把兩張顯卡插滿組成 32GB 顯存,就能安心在本地端開滿 128K 長文給團隊共用嗎?這次我們直接搬出工作站上的雙張 RTX 5060 Ti 16GB,針對三款主流 本地 LLM 進行容量、萬字閱讀掉速、抓重點準確率與多人並發壓測,用 10 張實測圖表帶你看清硬體與模型的真實極限。
在規劃企業內部知識庫時,最常搜尋 128K 長文多人並發實測 數據,卻發現規格表寫支援 128K,實際塞入數萬字合約後不是顯存爆掉,就是模型開始漏看開頭條件。本文不談理論空話,直接公布第一線環境的完整原始數據與曲線判讀,幫你避開本地部署最常見的隱形地雷。
本地 LLM 實測環境與本地端 AI 工作站規格配置
為了模擬中小企業與開發團隊在辦公室自建 本地端 AI 工作站規格配置 的真實場景,本次測試全數在單一高階工作站環境下執行,並嚴格對照純 CPU 運算(C0)、單張顯示卡(G0)與雙張顯示卡並行(D2)三種硬體配置。
若想先了解雙顯卡硬體規劃思路,先前我們整理的「雙卡 16GB 本地大模型實測」與「打造 32GB 顯存本地 LLM 架構指南」剛好可以互相參照。
測試工作站規格表
| 品名 | 型號/規格 |
|---|---|
| 工作站系統 | SuperWorkstation SYS-551A-T |
| CPU | Intel Xeon W5-3425 |
| 主機板 | Supermicro X13SWA-TF |
| 記憶體 | 32GB DDR5-4800 ECC RDIMM *2 |
| 測試資料庫儲存 | Kingston FURY Renegade G5 1TB |
| 作業系統 | Windows 11 專業版 |
三款受測模型與測試指標定義
本次挑選三款架構與量化精度不同的代表性模型進行評測,並嚴格區分指標定義,避免將「模型檔案大小」與「整卡顯存峰值」混為一談。
關於不同量化精度在推論速度與顯存占用上的取捨,也可以搭配我們先前寫的「GGUF 量化 Q4 Q6 Q8 雙卡實測」與「雙卡 Gemma 模型實測」一起對照:
- Gemma 12B UD-Q4:
- 120 億參數密集型(Dense)模型,採用 4-bit 動態量化,主打低顯存占用與長上下文支援。
- Nemotron Nano UD-Q4:
- 約 300 億總參數級距的混合專家(MoE)架構模型,採用 4-bit 動態量化,每次推論僅啟動部分專家參數。
- Ministral 14B Q8:
- 140 億參數密集型模型,採用高精度 8-bit 量化(Q8),權重本體較大且對 KV Cache 顯存頻寬要求高。

本地 LLM 32GB 顯存開 128K Context 爆顯存 OOM 邊界實測
在各大技術論壇上,組裝雙顯卡主機的網友最常討論的痛點就是 32GB 顯存開 128K Context 爆顯存 OOM:「明明兩張卡加起來有 32GB 顯存,為什麼開 128K 還是會跳出顯存不足?」這背後牽涉到模型權重本體、KV Cache 快取膨脹速度,以及單卡與雙卡的記憶體分配機制。
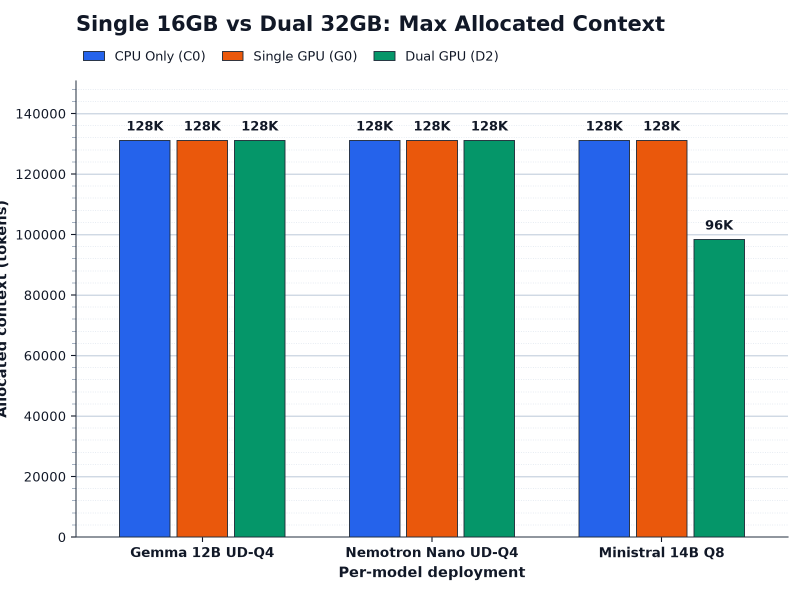
圖 1 中三組顏色分別代表不同的硬體運行模式:
- 藍色長條為純 CPU 運算(C0)
- 橘色長條為單張 16GB 顯示卡(G0)
- 綠色長條為雙張 16GB 顯示卡全載(D2)
從實測結果可以看到:
- Gemma 12B UD-Q4 與 Nemotron Nano UD-Q4 在三種模式下都能順利配置滿載的 128K(131,072 tokens)
- 但 Ministral 14B Q8 卻出現了反直覺的現象:
- 在純 CPU(C0)與單卡(G0,系統自動將部分層數卸載至 128GB DDR5 記憶體)時都能開到 128K
- 一旦切換到追求極致速度的雙卡全載(D2)模式,最大可用 Context 卻掉到 96K(98,304 tokens)
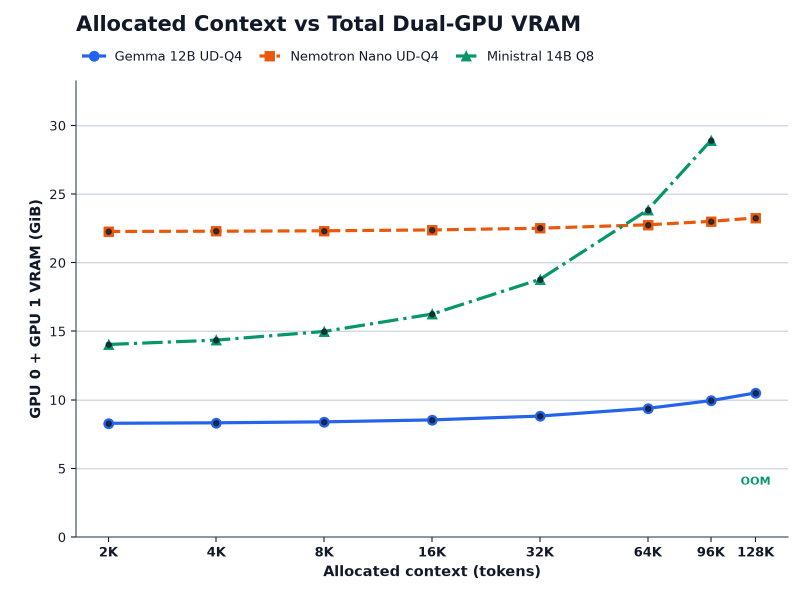
圖 2 折線圖記錄了雙卡(GPU 0 + GPU 1)在 NVML 層級實際吃掉的總顯存峰值(GiB):
NVML 是 NVIDIA Management Library(NVIDIA 管理函式庫)的縮寫,它是 NVIDIA 官方提供用來監控與管理自家顯示卡(GPU)硬體狀態的底層程式介面(API)。在實務應用中,NVML 主要有三個核心功能與意義:
1、驅動層級的硬體遙測:工程師在終端機輸入 nvidia-smi 指令時,畫面上跳出的顯示卡溫度、即時功耗(W)、風扇轉速、GPU 核心負載率,以及已使用的顯存(VRAM)容量,背後都是透過 NVML 直接向顯示卡驅動程式讀取的數據。
2、自動化監控與管理工具的基礎:在 Python 壓測腳本(透過
pynvml或nvidia-ml-py套件)或伺服器監控看板中,系統會以毫秒或秒為單位呼叫 NVML,用來記錄整段推論過程中的顯存峰值與功耗曲線。3、反映最真實的 OOM(顯存不足)邊界:推論引擎(如
llama.cpp)自己計算的通常只有「模型權重+KV Cache」的理論容量;而 NVML 回報的是整張顯示卡實際被占用的總顯存(包含 CUDA Context 初始化、顯示輸出緩衝與驅動程式開銷)。因此,觀察 NVML 顯存峰值才能最準確判斷距離顯示卡物理上限還剩多少安全空間。
- 藍色實線(Gemma 12B UD-Q4):
- 起點最省資源,開 2K Context 僅吃 8.29 GiB,一路拉滿到 128K 也只上升到 10.50 GiB,整段只增加了 2.21 GiB,就算單張 16GB 顯卡也能輕鬆駕馭。
- 橘色虛線(Nemotron Nano UD-Q4):
- 因為是 30B 級距模型,光載入權重在 2K 時就吃掉 22.28 GiB(遠超單張 16GB 上限,必須靠雙卡),但它的 KV Cache 極省,開到 128K 僅微幅增加到 23.26 GiB,曲線幾乎呈水平線。
- 綠色點劃線(Ministral 14B Q8):
- 曲線斜率最陡峭!2K 時僅需 14.04 GiB,但隨著 Context 翻倍,KV Cache 呈線性暴增,64K 時來到 23.84 GiB,96K 時直接衝上 28.91 GiB(扣除系統保留顯存已逼近 32GB 物理極限),因此在 128K 節點直接觸發 OOM(Out of Memory) 宣告失敗。
表 1-A:基礎顯存占用與 64K 成長幅度(2K vs 64K)
| 模型名稱 | 2K 雙卡顯存 | 64K 雙卡顯存 | KV Cache 暴增幅度 |
|---|---|---|---|
| Gemma 12B UD-Q4 | 8.29 GiB | 9.38 GiB | +1.09 GiB(極省) |
| Nemotron Nano UD-Q4 | 22.28 GiB | 22.76 GiB | +0.48 GiB(幾乎不漲) |
| Ministral 14B Q8 | 14.04 GiB | 23.84 GiB | +9.80 GiB(陡峭暴增) |
表 1-B:極限上下文與雙卡 OOM 邊界(96K vs 128K)
| 模型名稱 | 96K 雙卡顯存 | 128K 雙卡顯存 | 雙卡最高可用上限 |
|---|---|---|---|
| Gemma 12B UD-Q4 | 9.94 GiB | 10.50 GiB | 128K (131,072) |
| Nemotron Nano UD-Q4 | 23.01 GiB | 23.26 GiB | 128K (131,072) |
| Ministral 14B Q8 | 28.91 GiB | OOM (顯存不足) | 96K (98,304) |
本地 LLM 128K 長文多人並發與大海撈針漏讀實測對比
本地 LLM AI 工作站,除了要確認顯存裝得下之外,更關鍵的問題在於「讀得快不快」、「抓不抓得到重點」,以及「多人同時發問時會不會卡死」。以下透過:
- 128K 長文多人並發與大海撈針漏讀 實測數據,拆解單人長文壓測
- 圖 3 至圖 6
- 多人並發壓測
- 圖 7 至圖 10 的完整表現。
萬字長文閱讀速度(Prefill)與真實等待秒數
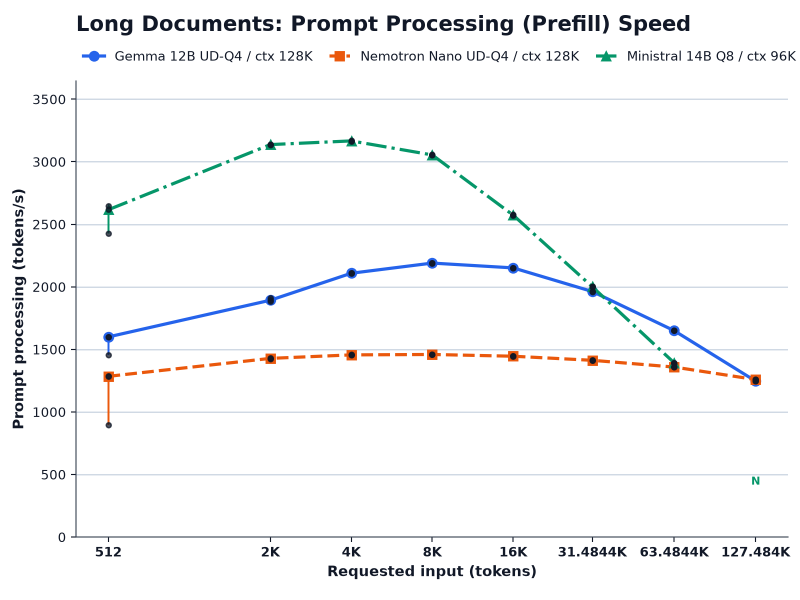
圖 3 橫軸為實際塞入的輸入長度(從 512 tokens 一路拉高到 127.48K tokens),縱軸為模型消化提示詞的 Prefill 速度(tokens/s,數據取三次測試中位數,黑點標示 min-max 波動範圍):
- 綠色點劃線(Ministral 14B Q8 / ctx 96K):
- 短中篇爆發力最強,在 4K 長度衝出全場最高
3,166.43 tokens/s,但因為注意力機制(Attention)計算量隨長度平方成長,到了 63.48K(65,008 tokens)時掉速 56.0%,降至1,392.28 tokens/s;而 127.48K 節點標示為 N(不支援該長度)。
- 短中篇爆發力最強,在 4K 長度衝出全場最高
- 藍色實線(Gemma 12B UD-Q4 / ctx 128K):
- 在 8K 長度達到峰值
2,189.78 tokens/s,隨後穩步下滑,63.48K 時為1,649.36 tokens/s,拉滿至 127.48K 時降至1,246.19 tokens/s(較峰值掉速 43.1%)。
- 在 8K 長度達到峰值
- 橘色虛線(Nemotron Nano UD-Q4 / ctx 128K):
- 展現出驚人的抗掉速韌性!雖然 8K 峰值僅
1,459.20 tokens/s,但一路讀到 127.48K 仍保有1,258.50 tokens/s(僅掉速 13.8%),在 128K 滿載長文閱讀速度上甚至反超 Gemma 12B。
- 展現出驚人的抗掉速韌性!雖然 8K 峰值僅
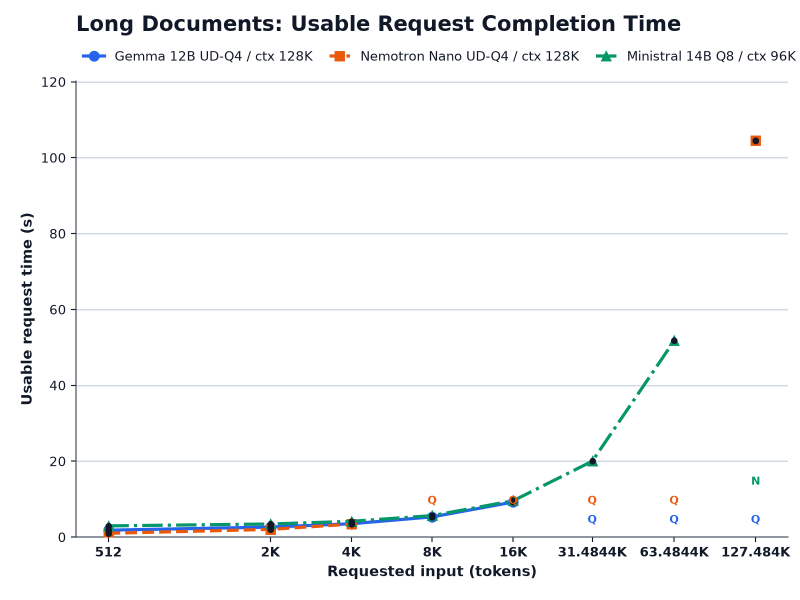
圖 4 統計的是「使用者送出長文後,直到完整拿到合格可用答案」的總等待秒數(包含 Prefill 閱讀時間與輸出生成時間)。特別注意圖中出現的英文字母標記:「Q」代表該長度測試中,模型回答未能達成 3/3 完整通過品質審查,因此圖表誠實留白不予連線;「N」代表超出 96K 上限未測。
- 綠色點劃線(Ministral 14B Q8):
- 唯一在 512 至 63.48K 全數過關並完整連線的模型,讀 16K 長文僅需
9.56 秒,讀 31.48K 需19.98 秒,讀 63.48K 則需51.74 秒。
- 唯一在 512 至 63.48K 全數過關並完整連線的模型,讀 16K 長文僅需
- 藍色實線(Gemma 12B UD-Q4):
- 16K 以內表現穩健(16K 完成時間為
9.21 秒),但從 31.48K 起因為品質未達標(標記 Q)而中斷連線。
- 16K 以內表現穩健(16K 完成時間為
- 橘色虛線(Nemotron Nano UD-Q4):
- 4K 以內完成僅需
3.40 秒,8K 至 63.48K 區間因部分樣本失誤標記為 Q,直到 127.48K 滿載時重新達成 3/3 全過,完整拿到答案需等待104.52 秒(min-max:104.44~104.52 秒)。
- 4K 以內完成僅需
宣稱支援 128K,超過幾萬字開始抓錯重點?
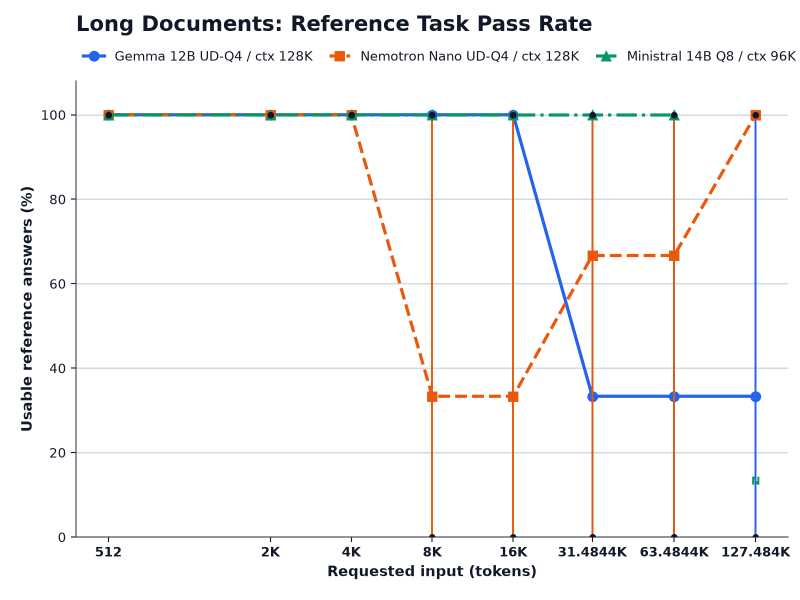
圖 5 是為了檢驗模型是不是「有讀進去但沒看懂」,我們在長文中埋入三個關鍵事實進行精準問答(每種長度測試 3 組變體):
- 綠色點劃線(Ministral 14B Q8):
- 在 512 至 63.48K 之間全程維持 100% 滿分通過率,精準度最高,可惜受限於 96K 顯存牆無法挑戰 127.48K(標記 N)。
- 藍色實線(Gemma 12B UD-Q4):
- 16K(16,384 tokens)以前皆為 100%,但一跨越 31.48K(32,240 tokens) 門檻,通過率便斷崖式跌至 33.3%(每 3 題只答對 1 題),且一路維持在 33.3% 直到 127.48K。
- 橘色虛線(Nemotron Nano UD-Q4):
- 在 4K 以內為 100%,但 8K 與 16K 突然掉到 33.3%,31.48K 與 63.48K 回升至 66.7%,127.48K 又回到 100%,顯示該量化版本在中長文注意力分配上存在明顯波動。
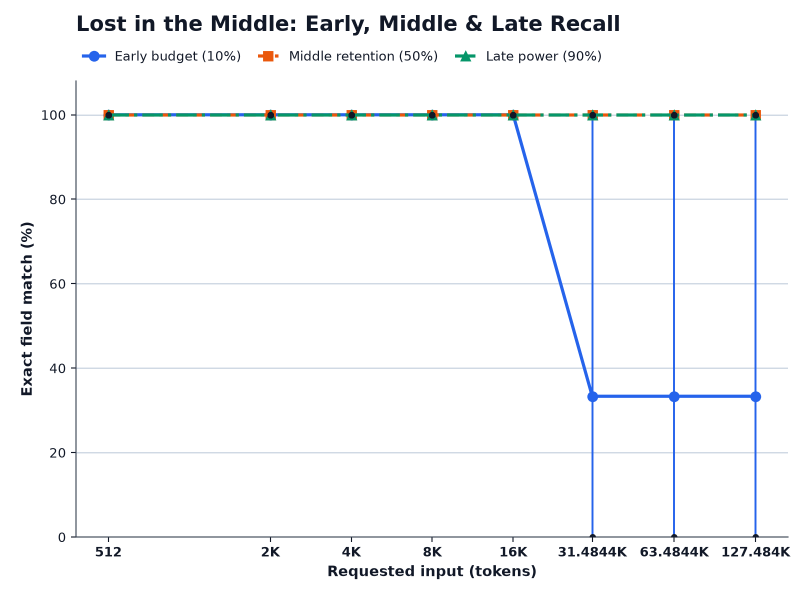
圖 6 針對 Gemma 12B UD-Q4 在 31.48K 之後通過率掉到 33.3% 的現象,我們進一步拆解三個關鍵欄位在文件中的埋藏位置(經人工逐筆核對確認並非格式截斷,而是實質內容抓錯):
- 橘色虛線(Middle retention 50%|文件中段)與 綠色點劃線(Late power 90%|文件後段):
- 兩條線從頭到尾緊貼在 100%,證明模型對近期記憶與中段資訊掌握度極佳。
- 藍色實線(Early budget 10%|文件開頭前 10%):
- 在 16K 以內保持 100%,但從 31.48K 起一路掉到 33.3%!
- 這揭露了一個反常識的實戰現象:傳統認知以為模型容易「迷失在中間(Lost in the Middle)」,但在這個長文結構任務中,超過 3 萬字後最先被模型遺忘的,反而是擺在文件最開頭(前 10%)的預算與限制條件。
1、2、4 人同時發問:多人並發延遲與整批總吞吐量測試
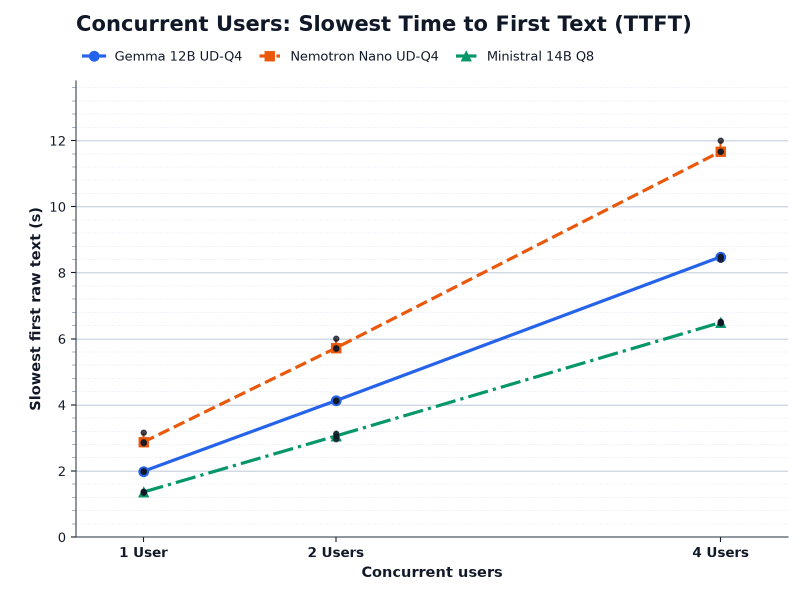
圖 7 在並發測試中,我們固定開 8K Context,讓 1、2、4 位使用者同時送出約 4K tokens(4,068~4,088 tokens) 的長文提問,測量「整批人當中運氣最差、最晚看到第一個字(Slowest TTFT)」的等待秒數:
- 綠色點劃線(Ministral 14B Q8):
- 受惠於高達 3,166 tokens/s 的超高閱讀速度,首字反應全場最快!1 人發問僅
1.36 秒,2 人同時發問為3.06 秒,就算 4 人同時丟入 4K 長文,最慢的人也只要等6.49 秒就開始看到畫面吐字。
- 受惠於高達 3,166 tokens/s 的超高閱讀速度,首字反應全場最快!1 人發問僅
- 藍色實線(Gemma 12B UD-Q4):
- 表現居次,1 人、2 人、4 人的最慢首字等待分別為
1.99 秒、4.13 秒與8.48 秒。
- 表現居次,1 人、2 人、4 人的最慢首字等待分別為
- 橘色虛線(Nemotron Nano UD-Q4):
- 閱讀速度較慢導致排隊效應明顯,1 人需
2.87 秒,2 人拉長到5.72 秒,4 人同時發問時最慢的人要等11.67 秒(最高達12.00 秒)才會看到第一個字。
- 閱讀速度較慢導致排隊效應明顯,1 人需
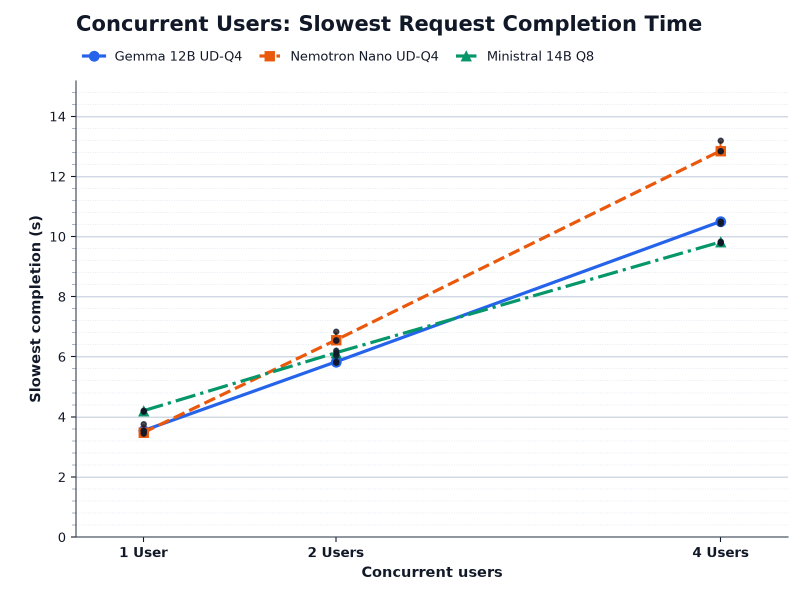
圖 8 是加上輸出生成時間後,觀察「全員都拿到完整回答」的最慢完成時間(Slowest completion):
- 1 人獨享時:
- Nemotron Nano(
3.47 秒)與 Gemma 12B(3.54 秒)因為單人生成速度較快,反而贏過 Ministral 14B(4.20 秒)。
- Nemotron Nano(
- 4 人並發時排名大洗牌:
- 綠色點劃線(Ministral 14B Q8) 以
9.82 秒逆轉奪冠,成為唯一在 10 秒內消化完 4 人長文請求的模型 - 藍色實線(Gemma 12B UD-Q4) 以
10.50 秒緊追在後 - 橘色虛線(Nemotron Nano UD-Q4) 則拉長到
12.85 秒墊底。
- 綠色點劃線(Ministral 14B Q8) 以
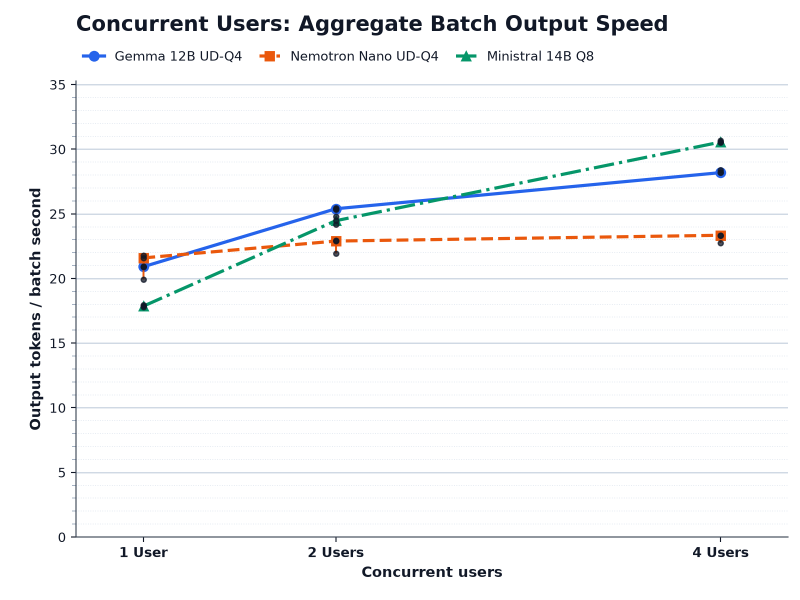
圖 9 說明許多人以為 30B MoE 模型因為每次啟動參數少,並發吞吐量一定會贏過 Dense 模型,但實測數據給出了截然不同的答案:
- 綠色點劃線(Ministral 14B Q8):
- 並發擴展性最強!1 人時整批總輸出為
17.86 tokens/s,2 人跳升至24.47 tokens/s,4 人並發時衝上全場最高的30.55 tokens/s(提升 71.1%)。
- 並發擴展性最強!1 人時整批總輸出為
- 藍色實線(Gemma 12B UD-Q4):
- 從 1 人的
20.91 tokens/s,穩定成長到 2 人的25.39 tokens/s與 4 人的28.19 tokens/s(提升 34.8%)。
- 從 1 人的
- 橘色虛線(Nemotron Nano UD-Q4):
- 雖然 1 人時以
21.59 tokens/s領先,但 2 人僅微幅升至22.89 tokens/s,4 人也停滯在23.34 tokens/s(僅提升 8.1%),整批總吞吐量反被 12B 與 14B Dense 模型大幅超車。
- 雖然 1 人時以
單卡 16GB 升級雙卡 32GB,多人共用每分鐘多產出幾份答案?
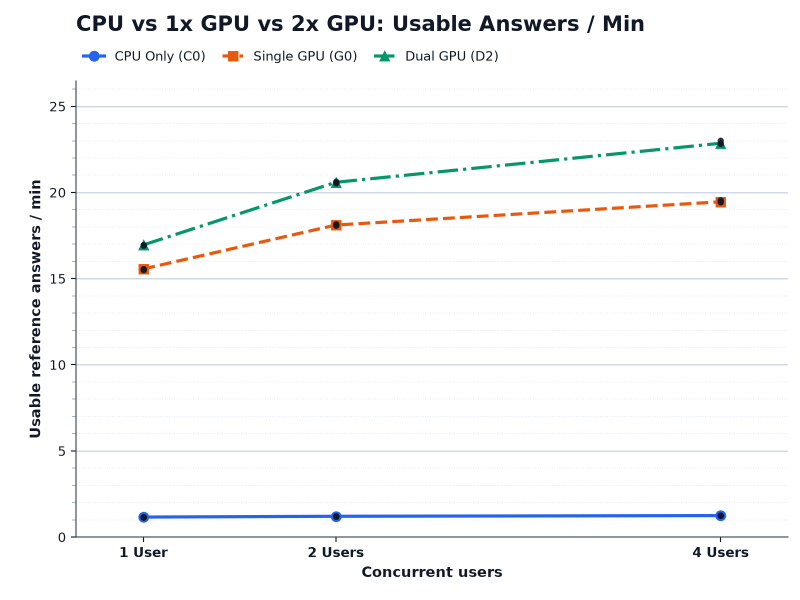
圖 10 以三種硬體都能完全放進 VRAM 的 Gemma 12B UD-Q4 為基準,換算成企業最在意的生產力指標「每分鐘可產出幾份合格參考答案(Usable answers / min)」:
- 藍色實線(CPU Only|C0):
- 即便動用 Xeon W5-3425 處理器與 128GB DDR5,1 人到 4 人並發每分鐘也只能產出
1.16至1.24 份答案,幾乎不具備多人即時服務能力。
- 即便動用 Xeon W5-3425 處理器與 128GB DDR5,1 人到 4 人並發每分鐘也只能產出
- 橘色虛線(Single GPU|G0,單張 RTX 5060 Ti 16GB):
- 裝上一張顯卡後產能暴增 13 倍以上!1 人為
15.56 份/分,2 人為18.11 份/分,4 人達到19.46 份/分。
- 裝上一張顯卡後產能暴增 13 倍以上!1 人為
- 綠色點劃線(Dual GPU|D2,雙張 RTX 5060 Ti 16GB):
- 升級雙卡後,1 人提升至
16.95 份/分(+8.9%),2 人提升至20.59 份/分(+13.7%),4 人並發更衝上22.85 份/分,比單卡每分鐘多產出3.40 份合格答案(提升 17.5%)。
- 升級雙卡後,1 人提升至
表 2-A:三款模型最慢首字等待時間(Slowest TTFT)
| 受測模型(雙卡 D2) | 1 人發問 | 2 人並發 | 4 人並發 |
|---|---|---|---|
| Ministral 14B Q8 | 1.36 秒 | 3.06 秒 | 6.49 秒 |
| Gemma 12B UD-Q4 | 1.99 秒 | 4.13 秒 | 8.48 秒 |
| Nemotron Nano UD-Q4 | 2.87 秒 | 5.72 秒 | 11.67 秒 |
表 2-B:全體完成回答時間與 4 人整批總吞吐量
| 受測模型(雙卡 D2) | 1 人完成 | 4 人全體完成 | 4 人整批總吞吐量 |
|---|---|---|---|
| Ministral 14B Q8 | 4.20 秒 | 9.82 秒 | 30.55 tokens/s |
| Gemma 12B UD-Q4 | 3.54 秒 | 10.50 秒 | 28.19 tokens/s |
| Nemotron Nano UD-Q4 | 3.47 秒 | 12.85 秒 | 23.34 tokens/s |
表 2-C:硬體配置升級產能對比(Gemma 12B UD-Q4 每分鐘合格答案數)
| 硬體配置模式 | 1 人產能 | 2 人並發產能 | 4 人並發產能 |
|---|---|---|---|
| 純 CPU (Xeon W5-3425) | 1.16 份/分 | 1.20 份/分 | 1.24 份/分 |
| 單張 RTX 5060 Ti 16GB | 15.56 份/分 | 18.11 份/分 | 19.46 份/分 |
| 雙張 RTX 5060 Ti 16GB | 16.95 份/分 | 20.59 份/分 | 22.85 份/分(+17.5%) |
單卡 16GB 升級雙卡 32GB 企業知識庫部署避坑指南
本次跑出的 245 筆實機基準數據,如果想評估 單卡 16GB 升級雙卡 32GB 企業知識庫部署 細節,打造高穩定度 本地 LLM AI 伺服器,請務必記住以下四個實戰守則。
- 高精度 Q8 模型切勿硬開 128K Context:
Ministral 14B Q8 雖然閱讀速度最快、4 人並發吞吐量稱王、64K 以內準確率 100%,但它在 96K Context 時就已經吃掉 28.91 GiB 顯存,開 128K 會直接 OOM 當機。實務部署請將--ctx-size上限鎖定在 65536(64K)或 98304(96K),保留安全顯存緩衝。 - 單篇超過 3 萬字的長文,別迷信 4-bit 量化模型的「宣稱 128K」:
實測證實 Gemma 12B UD-Q4 超過 31.48K 後,開頭前 10% 條件的召回率會從 100% 掉到 33.3%;Nemotron Nano UD-Q4 在 8K~64K 之間也只有 33.3%~66.7% 通過率。如果業務需要審閱超過 3 萬字的完整合約,建議改用 Ministral 14B Q8(控制在 64K 內),或搭配 RAG 分段檢索把單次輸入壓在 16K 以內。 - 重度提示詞(System Prompt)請重複強調關鍵規則:
從圖 6 的位置實測可以發現,當長文拉長到 3 萬字以上時,最容易被漏讀的是放在最開頭(前 10%)的條件。撰寫長文分析模板時,除了在開頭定義輸出格式與預算限制,務必在文件最末端(90% 之後)再次重申核心限制,利用模型對後段 100% 的高注意力確保不漏接。 - 單卡 16GB 該不該升級雙卡 32GB?看你的模型大小與並發人數:
如果你只跑 12B Q4 級距且只有 1 人使用,單卡(15.56 份/分)與雙卡(16.95 份/分)體感差距僅 8.9%,升級 CP 值有限;但只要你需要載入 22GB 以上的 30B 級距模型(單卡根本塞不下),或是有 4 人以上同時共用(雙卡產能提升 17.5% 且延遲明顯降低),這組雙顯卡就是極具性價比的入門企業級工作站方案。
若要將模型接上 本地 LLM 內部知識庫或團隊聊天介面,也可以參考「Modelfile 載入 GGUF 到 Ollama 與 AnythingLLM 教學」、「自架 AnythingLLM 與 Ollama 打造 ChatGPT 替代方案」以及「Windows 11 Docker 本地 AI 助手實作」。
常見問題 FAQ:本地 LLM 與 128K 長文多人並發實測
Q1:雙張 RTX 5060 Ti 16GB 合計 32GB 顯存,所有 14B 模型都能開滿 128K Context 嗎?
不一定,取決於量化精度。12B UD-Q4 模型開滿 128K 僅需 10.50 GiB 顯存;但 14B Q8 高精度模型在 96K 時就已占用 28.91 GiB,開到 128K 會直接觸發顯存不足(OOM),最高只能穩定運行 96K。
Q2:為什麼單張 16GB 顯卡(G0)反而能把 Ministral 14B Q8 開到 128K,雙卡(D2)卻只能開 96K?
因為單卡 16GB 裝不下 14B Q8 與 128K KV Cache 時,推論引擎會自動將部分模型層數與快取卸載(Offload)到主機板的 128GB DDR5 系統記憶體中硬撐(代價是速度大幅變慢);而雙卡全載模式為了追求全 GPU 高速運算,受限於 32GB 物理顯存天花板而在 96K 觸頂。
Q3:本地 AI 處理萬字長文時,閱讀速度(Prefill)會隨字數增加變慢多少?
不同架構差異極大。Ministral 14B Q8 從 4K 峰值(3,166.43 tokens/s)拉長到 63.48K 時掉速 56.0%(剩 1,392.28 tokens/s);Gemma 12B UD-Q4 從 8K 峰值(2,189.78 tokens/s)到 127.48K 掉速 43.1%;Nemotron Nano UD-Q4 最抗跌,到 127.48K 僅掉速 13.8%(維持 1,258.50 tokens/s)。
Q4:宣稱支援 128K Context 的模型,超過幾萬字後會開始抓錯重點?
實測顯示 Gemma 12B UD-Q4 在 16K 以內通過率為 100%,但一超過 31.48K(32,240 tokens)通過率就驟降至 33.3%;若要維持 100% 精準抓重點,建議將 4-bit 量化模型的單次輸入控制在 16K 以內,或改用 Q8 量化模型(64K 內維持 100%)。
Q5:在數萬字的長文件中,開頭、中間、結尾哪個位置最容易被模型漏讀?
根據 Gemma 12B UD-Q4 的位置召回實測,超過 31.48K 後,文件中段(50%)與後段(90%)的召回率都維持在 100%,反而是放在文件最開頭(前 10%)的資訊召回率掉到 33.3%,最容易被模型遺忘。
Q6:4 個人同時丟入 4K 長文發問時,三款模型誰的首字等待時間(TTFT)最短?
Ministral 14B Q8 最快,4 人同時發問時最慢首字等待僅需 6.49 秒;其次是 Gemma 12B UD-Q4 的 8.48 秒;Nemotron Nano UD-Q4 則需要 11.67 秒。
Q7:多人並發時,30B MoE 模型的整批總吞吐量能贏過 12B 或 14B Dense 模型嗎?
實測結果顯示無法勝出。在 4 人並發時,Nemotron Nano UD-Q4(30B MoE)的整批總輸出速度僅 23.34 tokens/s,落後於 Gemma 12B UD-Q4 的 28.19 tokens/s 與 Ministral 14B Q8 的 30.55 tokens/s。
Q8:單張 RTX 5060 Ti 16GB 升級到雙張 32GB 後,多人共用每分鐘能多產出幾份答案?
以 Gemma 12B UD-Q4 處理 4K 長文為例,單卡在 1、2、4 人並發時每分鐘產出 15.56、18.11、19.46 份合格答案;升級雙卡後提升至 16.95、20.59、22.85 份,4 人並發時每分鐘多產出 3.40 份答案(產能提升約 17.5%)。
Q9:如果只用高階工作站 CPU(Xeon W5-3425 + 128GB DDR5)不裝顯卡,跑 12B 模型夠用嗎?
完全不夠多人使用。純 CPU 模式下處理 4K 長文,無論 1 人或 4 人並發,每分鐘都只能產出 1.16 至 1.24 份答案,4 人同時發問要等超過 3 分鐘(193 秒)才能完成,僅適合極低頻率的背景批次測試。
Q10:為什麼圖 4 長文完成時間折線圖中,Gemma 12B 與 Nemotron Nano 在某些長度沒有連線?
這是因為本測試採取嚴格品質門檻,只要該長度下的 3 次測試未能達成 100% 參考答案通過率(標記為 Q),系統便不將該時間計入「合格可用完成時間」,避免呈現「速度很快但答案全錯」的無效數據。
本地 LLM 實測總結:128K 長文與多人並發部署建議
實測證實,落地執行 本地端雙顯卡跑大模型選購建議 時,雙卡 32GB 配置的 本地 LLM 能讓 14B Q8 在 4 人並發跑出 30.55 tokens/s 且 64K 內準確率 100%。
只要避開 128K 爆顯存邊界,並留意 12B Q4 超過 3 萬字易漏讀開頭條件,就能建置穩定知識庫。
📚 Local AI 本地部署 系列
← Local AI 本地部署指南:Ollama、AnythingLLM、Whisper