在本地部署大型語言模型時,16GB 顯存是主流硬體門檻。本篇針對 Llama 3 8B 與主流開源模型進行 GGUF 評測與 8B 模型實測,透過 llama.cpp 剖析推論速度與記憶體瓶頸,找出最強性價比之選。
在 8B 級別的模型生態中,開源社群提供了眾多選擇。本次基準測試選定 6 款最具代表性的模型進行對比:
基準量化對比組:Bartowski Llama_3_8B_Q4_K_M、QuantFactory Llama_3_8B_Q4_K_M
在地繁體中文微調組:Llama 3 Taiwan 8B Q8_0、Llama 3 Breeze2 8B Q8_0
不同架構代表組:Mistral 7B v0.3 Q8_0、IBM 開源的 Granite 3.1 8B Q8_0
Llama 3 8B 實測平台與模型下載來源
測試硬體
GPU:NVIDIA T4 16GB VRAM GPU (PCIe Gen3)
SSD:PCIe Gen4 NVMe SSD *2,使用 Intel VROC NVMe RAID 加快模型讀寫速度
CPU:Intel Core i5-12400
Memory:32GB *2
主機板:Asus Z790-Plus WiFi D4
軟體與模型
GUF 模型下載:Hugging Face 官網
1、Mistral 7B v0.3 Q8_0:MaziyarPanahi
2、Granite 3.1 8B Q8_0:Bartowski
3、Llama 3 8B Q4_K_M:Bartowski
4、Meta-Llama-3-8B-Instruct.Q4_K_M:QuantFactory
5、Llama-Breeze2-8B-Instruct-Text-GGUF:Mradermacher
6、Llama-3-Taiwan-8B-Instruct:Chienweichang
推論引擎:ggml-org/llama.cpp GitHub Releases 頁面
接著來看透過不同 Context 長度、顯存載入邊界與消耗功耗實測數據,剖析 16GB 顯卡環境下的極限表現。
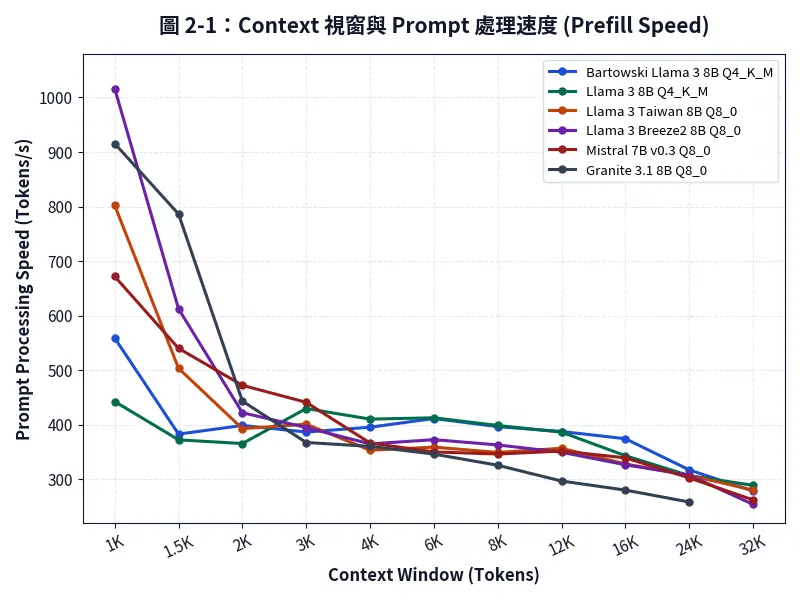
Context 視窗與 Prompt 處理速度 (Prefill Speed)
本圖表記錄 6 款 8B 級模型在 Context 視窗從 1K(1,024)逐步堆疊至 32K(32,768)長度時,Prompt 預處理速度(Speed_PP,單位 Tokens/s)的衰減走勢。
在 1K 短文本階段,各模型呈現極大分化(440 ~ 1,016 tok/s);隨著長度超過 3K,所有模型的預處理速度均平緩收斂至 260 ~ 400 tok/s 區間。
與硬體環境(如單卡 16GB)的直接關係
Prefill 階段負責大批次提示詞的矩陣乘法運算(GEMM)。在 16GB VRAM 硬體下,8B 模型的權重僅佔 5GB ~ 8.7GB,這讓 GPU 擁有充裕的空間在內部快取中展開注意力矩陣運算。
圖中可見在 16K 以內的長度下,Llama 3 架構(尤其是 Q4_K_M)的預處理速度普遍維持在 350 tok/s 以上,展現出高度適合高並發 RAG 檢索與代碼補全應用的優勢。
【優缺點分析】
表現最佳 (Llama 3 Breeze2 8B Q8_0 短文本 / Llama_3_8B_Q4_K_M 長文本)
- 優點:
- Breeze2 在 1K 時預處理速度高達 1,016.27 tok/s,Granite 亦達到 915.56 tok/s,在單輪簡短問答時能提供即時的響應體驗。
- 而 Llama 3 Q4_K_M 系列在 4K ~ 16K 的中長文本階段抗衰減表現最佳,速度穩定維持在 380 ~ 413 tok/s。
表現最差 (Granite 3.1 8B Q8_0 在超長文本)
- 缺點:
- 在 24K Context 時,Granite 3.1 的預處理速度下滑至 258.68 tok/s 是全部測試模型最低的模型。
- 且在 32K 階段無法完成完整推論數據。
- 底層原因剖析:
- Granite 架構在處理超長 Attention 時,KV Cache 的巨量讀寫使計算核心受到記憶體通道阻塞;加上 Q8_0 量化格式缺乏 Q4 的權重壓縮優勢,在批次矩陣計算時跨暫存器傳輸量翻倍,導致長上下文預處理出現顯著的效能滑落。
Context 視窗與 VRAM 峰值用量 (KV Cache 增長)
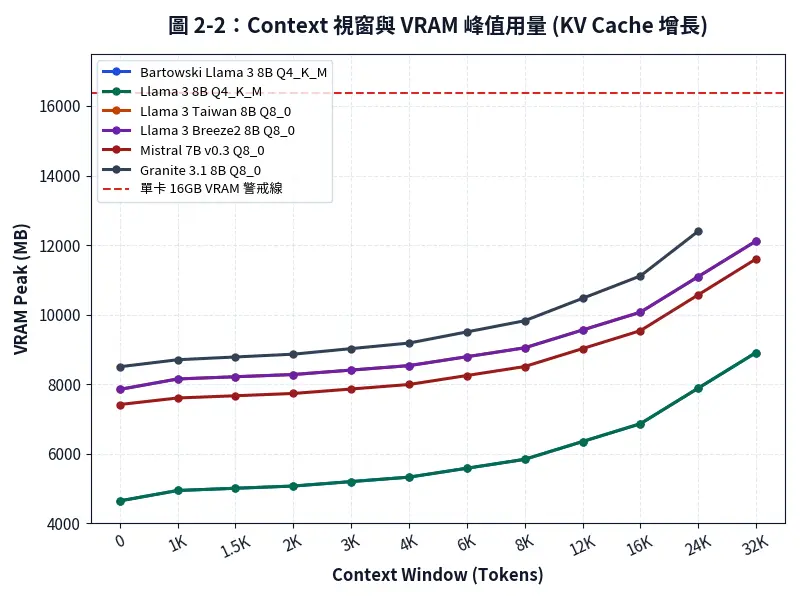
目的是觀察 Context 大小從 0(純模型載入)逐步遞增至 32K 時,各模型消耗 VRAM 峰值(MB)的增加曲線。
曲線斜率直接反映了各模型在長文本推論時,分配與維護 KV Cache(鍵值快取)對 VRAM 的實際消耗速度。
與硬體環境(如單卡 16GB)的直接關係
圖中紅色虛線標註了常見 單卡 16GB VRAM(16,384 MB) 的實體安全警戒線。
- 全數安全通過:
- 所有 6 款 8B 模型在 32K 極限長度下,峰值均未超過 12.4GB,全部都在 16GB VRAM 限制之下。
- 單卡彈性極大:
- Q4_K_M 版本在 32K 時僅消耗 8,907 MB(約 8.7GB),意味著單張 16GB 顯卡不僅能毫無壓力吃滿 32K 上下文,還能同時容納作業系統桌面進程,甚至支援多用戶並發請求(Batched Inference)。
【優缺點分析】
表現最佳 (Bartowski Llama_3_8B_Q4_K_M / Llama_3_8B_Q4_K_M)
- 優點:
- 基礎載入僅需 4,639 MB,即使拉滿到 32K Context,總顯存依然穩壓在 8.9GB,顯存佔用效率極高。
表現最差 (Granite 3.1 8B Q8_0 / Llama 3 Breeze2 & Taiwan 8B Q8_0)
- 缺點:
- Q8_0 版本基礎顯存就已吃掉 7.8GB ~ 8.5GB,在 32K 時達到 12,115 MB。雖然單卡 16GB 依然能載入,但已無多餘空間支援更大的並發量。
- 假使要使用 Q8_0 版本更大參數模型 (12B, 27B,…),或想要支援更大的並發量,可以考慮雙卡架構:雙卡 RTX 5060 Ti 16GB 跑 MoE 26B vs 12B Dense,32GB VRAM 高 CP 值首選
各款 8B 主流模型極限效能與每瓦能效比
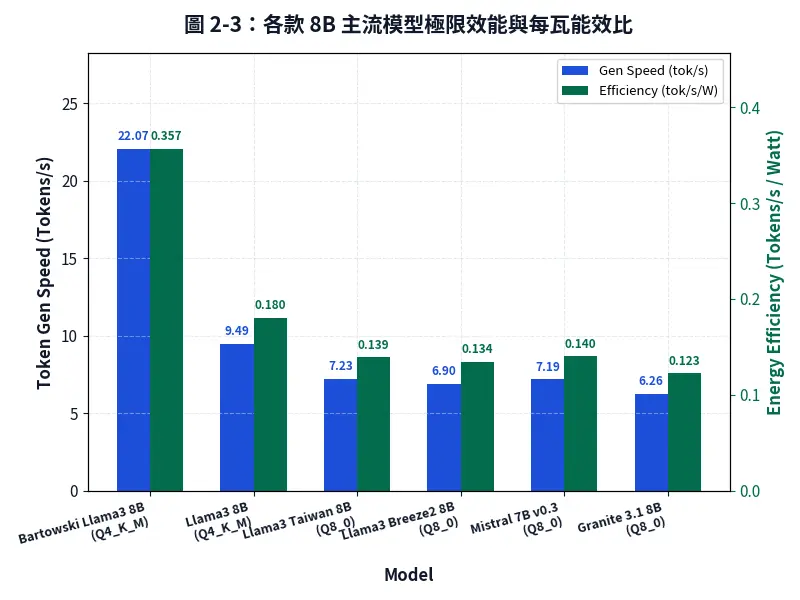
在完全由 GPU(NGL=99, CTX=1024)的推論條件下,以雙 Y 軸柱狀圖對比【 Token 生成速度(藍柱,tok/s)】與【每瓦特效能比(綠柱,Tokens/s per Watt)】。
與硬體環境(如單卡 16GB)的直接關係
Token 生成屬於典型的 Memory-Bandwidth Bound(記憶體頻寬瓶頸)。GDDR 記憶體頻寬決定了 GPU 每秒能輪轉幾次 8B 權重。圖表清楚看到結果:同樣是 8B 模型與相同的硬體,量化轉換最佳化程度與位元度對輸出速度產生了決定性的差異。
【優缺點分析】
表現最佳 (Bartowski Llama_3_8B_Q4_K_M)
- 優點:
- 以 22.07 tok/s 的生成極速與 0.357 tok/s/W 的能效比奪下雙料冠軍。
- 核心關鍵:
- 相較於原生未優化版 Llama_3_8B_Q4_K_M 的 9.49 tok/s,Bartowski 版本速度暴增 132.6%(2.32 倍)。
- 因為優化版在權重轉換時針對 CUDA Kernel GEMM 進行了記憶體連續對齊與快取預取(Cache Prefetch)優化,大幅消除了 GPU 讀取權重時的等待延遲。
表現最差 (Granite 3.1 8B Q8_0 / Llama 3 Breeze2 8B Q8_0)
- 缺點:
- 生成速度僅有 6.26 ~ 6.90 tok/s,能效比僅 0.123 ~ 0.134 tok/s/W,速度不到 Bartowski 版本的 32%。
繁體中文微調取捨
Llama 3 Taiwan 8B Q8_0(7.23 tok/s)與 Breeze2 8B Q8_0(6.90 tok/s)因使用高精度 Q8_0 量化,顯存頻寬消耗增加,生成速度落在 7 tok/s 左右。若追求 20 tok/s 以上的流暢體驗,建議選擇繁中微調模型的 Q4_K_M 衍生版本。
常見問題
Q1:16GB GPU 跑 Llama 3 8B 夠用嗎?
A1:完全夠用。Llama 3 8B 在 Q4_K_M 量化下僅需約 5GB 顯存,即使 Context 視窗開滿至 32K,總顯存佔用也僅 8.9GB,遠低於 16GB 門檻。
Q2:為什麼同樣是 Llama 3 8B Q4_K_M,Bartowski 版本速度快了一倍以上?
A2:Bartowski 在 GGUF 量化轉換時優化了權重排布與 Tensor 記憶體連續性,大幅降低了 llama.cpp 底層 CUDA Kernel 讀取時的 Cache Miss,因此推論速度高達 22.07 tok/s,遠勝原生未優化版的 9.49 tok/s。
Q3:繁體中文微調模型(如 Taiwan 8B、Breeze2)速度會比較慢嗎?
A3:主要是因為社群常見版本多採用 Q8_0(8-bit)量化。8-bit 權重體積比 4-bit 大一倍,在 GPU 頻寬受限時生成速度會降至 7 tok/s 上下。若改用 Q4_K_M 格式,速度同樣能大幅提升。
Q4:8B GGUF 模型在 32K 長文本時會爆 VRAM 嗎?
A4:不會。實測 6 款 8B 模型在 32K 上下文長度下,顯存峰值最高為 12.1GB(Q8_0)與 8.9GB(Q4_K_M),單卡 16GB 顯卡均能安全穩定運行。
Q5:Prompt 預處理速度 (Prefill Speed) 代表什麼?為什麼重要?
A5:預處理速度代表模型吸收長篇提示詞(Prompt)的快慢。在進行 RAG 文檔檢索、代碼庫分析或長對話時,高預處理速度能顯著縮短使用者送出問題後的【首字反應時間(Time to First Token)】。
Q6:Q4_K_M 與 Q8_0 在日常使用上有明顯智商差距嗎?
A6:在多數日常對話、翻譯與摘要任務中,Q4_K_M(4-bit 混合量化)的困惑度(Perplexity)損失極微小,盲測幾乎感受不到差異,但能換來 2 到 3 倍的推論速度提升。
Q7:8B 模型滿載推論時的功耗是多少?很耗電嗎?
A7:不高。實測 16GB 單卡在 8B 模型全卸載推論時,平均功耗僅在 51W ~ 62W 之間,每小時耗電約 0.06 度,成本非常低廉。
Q8:Mistral 7B v0.3 與 Llama 3 8B 相比表現如何?
A8:Mistral 7B v0.3 在 Q8_0 下具備 803 tok/s 的優秀短文本預處理速度,生成速度約 7.19 tok/s,表現與 Llama 3 Q8_0 相當,但顯存佔用(7.6GB)略低於 Llama 3 的 8.1GB。
Q9:如何選擇 8B 模型最適合的量化級別?
A9:若追求每秒 20 字以上的流暢打字體驗與低顯存,首選 Q4_K_M;若用於高精度代碼編寫或數理邏輯推理,且對速度要求不高(7~8 tok/s 即可接受),可選擇 Q8_0。
Q10:既然有 Google AI Pro 或 ChatGPT,為什麼工程師還要在本地跑 Llama 3 8B?
A10:雲端 AI 雖然強大,但對開發者而言存在許多實務方面的考量,例如:
1、公司程式碼上傳的資安風險
2、個人密碼或 API Key 的重要資訊
3、頻繁的速率限制(Rate Limit)
正如我們在Google AI Pro 實測 5 大致命缺陷一文中的分析,商業雲端訂閱並非萬靈丹;反觀本地 16GB GPU 跑 8B 模型,能做到百分之百隱私隔離、無連網限制與極低延遲,兩者通常是互補而非單純取代。
Llama 3 8B 依然是本地部署的性價比首選
看完一整輪實測,Llama 3 8B 可以說是目前平衡感最好的一款模型。對只能用單卡 16GB GPU 在自己電腦跑的人來說,它的 VRAM 吃得少,跑起來又順又快。不管是當寫程式的小幫手、做文章摘要還是跑日常工作流,要挑一顆省資源又聰明的開源主力,選它準沒錯。
| 模型名稱 | 量化級別 | 生成速度 (Token/s) | 預處理速度 (Token/s) | VRAM 峰值 (MB) | 平均功耗(ave.Watt) | 每瓦效能 (Token/s/W) |
|---|---|---|---|---|---|---|
| Bartowski Llama 3 8B | Q4_K_M | 22.07 | 993.58 | 4,939.0 | 61.87 | 0.357 |
| Llama 3 8B | Q4_K_M | 9.49 | 699.11 | 4,939.0 | 52.68 | 0.180 |
| Llama 3 Taiwan 8B | Q8_0 | 7.23 | 712.13 | 8,147.0 | 51.94 | 0.139 |
| Mistral 7B v0.3 | Q8_0 | 7.19 | 803.30 | 7,600.0 | 51.22 | 0.140 |
| Llama 3 Breeze2 8B | Q8_0 | 6.90 | 754.37 | 8,147.0 | 51.31 | 0.134 |
| Granite 3.1 8B | Q8_0 | 6.26 | 591.24 | 8,700.0 | 51.06 | 0.123 |
📚 Local AI 本地部署 系列
← Local AI 本地部署指南:Ollama、AnythingLLM、Whisper