許多工程師在自建AI工作站時,最常踩坑的難題就是 GGUF 量化怎麼選?大家總以為位數越高、模型越大就越準,但實際拿來跑繁中採購與維運文件才發現,能開機載入跟能交出可用答案,完全是兩回事!
面對 Q4、Q6、Q8 怎麼選的抉擇,只看跑分榜很容易白花預算。這篇本地 LLM 模型量化選擇指南,直接用雙卡 Nvidia RTX 5060 Ti 16GB 實測數據,帶你看清檔案大小、推論等待秒數與自動化系統串接的真實代價。
Table of Contents
- 決定 GGUF 量化怎麼選之前:先看懂雙卡 16GB 工作站與繁中實測規則
- 同樣下載 Q8 高規格模型,為什麼有的能交差、有的卻拿零分?
- Q4 和 Q8 差多少?從Gemma 12B 實測看 GGUF 檔案大小與品質的真相
- 小模型 Q8 還是大 MoE 模型 Q4?揭開 GPU offload RAM/CPU 的代價
- 兩張 16GB 顯示卡不等於 32GB!升級AI工作站必看的 VRAM 與 RAM 配置
- 答案明明算對卻拿零分?破解本地 AI JSON 輸出不穩定的自動化陷阱
- 四種實務情境幫你找到高CP值方案
- 常見問題 FAQ
- GGUF 量化怎麼選?選對硬體配置打造高 CP 值本地 AI 工作站
決定 GGUF 量化怎麼選之前:先看懂雙卡 16GB 工作站與繁中實測規則
網路上常見的模型跑分,幾乎都在比每秒能噴幾個字(tokens/s),但花大錢組裝 AI 工作站,真正在乎的從來不是這種虛榮指標,而是實際運作的能耐:【丟一份繁體中文採購合約給它,裡面的金額與工時能不能算對?吐出來的資料能不能直接寫進公司資料庫?】
為了測出真正能用的硬實力,雙卡 Nvidia RTX 5060 Ti 工作站上把所有推論參數全部鎖死,不賭運氣、不手動改答案,直接用實測數據說話。
工作站硬體規格
| 品名 | 型號/規格 |
|---|---|
| 工作站系統 | SuperWorkstation SYS-551A-T |
| CPU | Intel Xeon W5-3425 |
| 主機板 | Supermicro X13SWA-TF |
| 記憶體 | 32GB DDR5-4800 ECC RDIMM *2 |
| GPU | 2* NVIDIA GeForce RTX 5060 Ti 16GB |
| 作業系統 | Windows 11 專業版 |
兩種部署模式
| 品名 | 型號/規格 |
|---|---|
| 推論引擎 | llama.cpp |
| 上下文長度 | 8,192 |
| 回答上限 | 512 |
| 執行緒 | 24 |
| 雙卡平均分攤權重 | layer split 1:1 |
| KV 快取 | f16 |
| Flash Attention | 開啟 |
| 溫度 | 0 |
| mmap | 開啟 |
硬體負載模式#1
全上顯示卡模式(Requested 99):
要求將模型 99 層權重盡可能塞進兩張 RTX 5060 Ti 顯示卡裡跑,測試顯示卡全力衝刺的表現。
硬體負載模式#2
混合部署模式(Fixed 20):
預先排定的獨立測試,固定只放 20 層在雙顯示卡上,剩下的全部丟給 CPU 與主機記憶體(RAM)執行。
三份繁中企業文件與四種實務考題
設計了【硬體採購合約、伺服器維運紀錄、機房儲存擴充規格書】三份完全貼合台灣職場情境的繁中技術文件,每份文件各自設計 4 種實務題型,總共 12 道考題:
- 擷取核准資訊(Fact):
- 直接考驗繁中採購文件 LLM 擷取實力。
- 請 AI 精準抓出合約核准金額、設備型號與專案負責人,只要數字看漏或抓錯欄位就算不及格。
- 數據計算與方案比較(Calculation):
- 考驗模型對規格與數字的理解。
- 要求 AI 看懂文件裡各家廠商的報價與維護工時,自己做加減乘除,算出差價並挑出成本最佳解。
- 未提及資訊判斷(Missing):
- 防範本地 LLM 缺失資訊幻覺的關鍵考驗。
- 我們故意提問文件裡根本沒寫的隱藏費用與交期,測測看 AI 會不會老實回答【文件未提供】,徹底揪出愛瞎掰胡扯的模型。
- 整理長篇文件摘要(Summary):
- 考驗長文消化與重點整理能力。
- 因為摘要好壞很難單純靠程式比對,加上這輪測試還沒由人工逐字審查給分,為了讓實測數據維持百分之百的客觀標準,摘要題先不計入自動過關率。
前三類客觀題共有 9 道不同題目(3 份繁中技術文件 * 3 種實務考題),每道題目固定連續跑 3 次來捕捉系統推論時間的波動,換句話說,每個模型在每種模式下,都必須通過總共 27 次實際測試的作答檢驗。
同樣下載 Q8 高規格模型,為什麼有的能交差、有的卻拿零分?
很多人在挑選本地模型時都有個迷思:【既然工作站都插了兩張 16GB 顯示卡,當然直上精準度最高的 Q8_0 版本,算出來肯定最準!】 但實際把日常最熱門的三款 Q8 模型接上公司的自動化流程,結果馬上讓人驚呆!
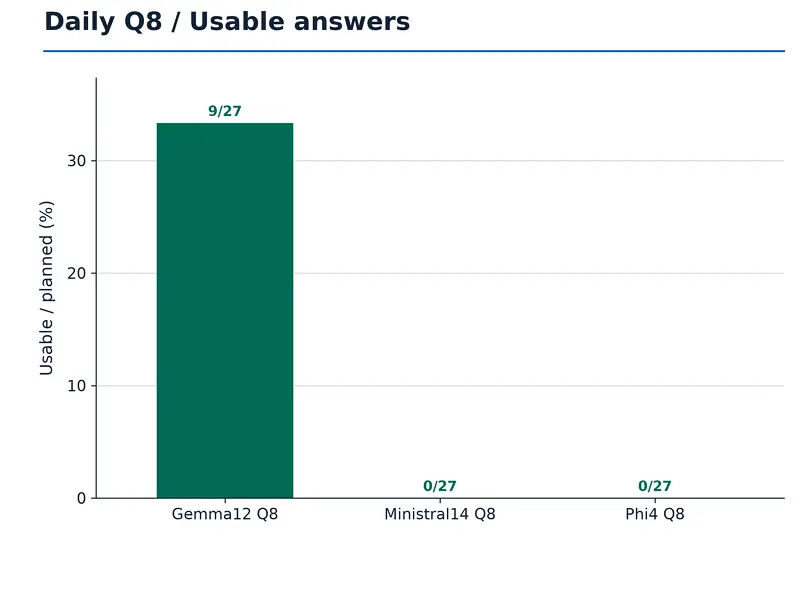
圖 1:雙卡全上顯示卡模式(Requested 99)下,9 道客觀題各跑 3 次(共 27 次作答)。柱子高度代表同時符合【內容正確、引用來源合格、且為純 JSON 格式】的過關比率。
在總共 27 次的嚴格測試中,Google 的 Gemma4 12B Q8 順利過關 9 次(可用產率 33.33%);但同為高規格 Q8 的 Ministral3 14B 與微軟 Phi-4,在圖 1 的系統自動化標準下,竟然雙雙掛蛋慘吞 0/27。
先別急著把 Ministral 和 Phi-4 砍掉,它們拿零分絕對不是因為看不懂繁體中文。在企業自動化串接的流程裡,系統對介面格式的要求非常嚴格:除了答案與引用標記必須全對,還明文限制【只能輸出乾淨的純 JSON,嚴禁夾帶任何多餘字眼或標籤】。這兩款模型到底踩到什麼相容性地雷?後面的圖 10 會直接把原始測試數據攤開來為大家解決疑惑。
答案能否順利交卷是一回事,另一個大家最關心的痛點是:本地模型文件處理要等多久?
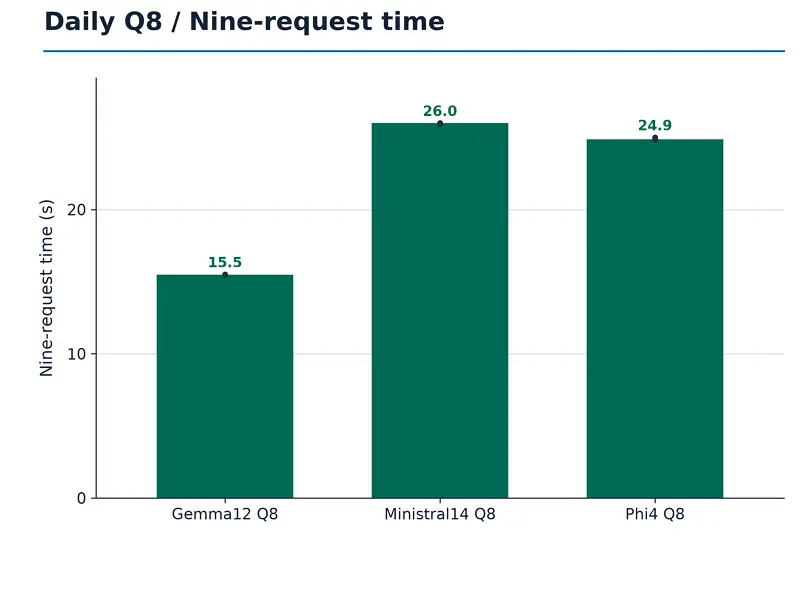
圖 2:同批三款 Q8 模型在雙卡模式下,連續跑完 9 道客觀題的總等待秒數(取三次測試的中位數,不包含模型載入時間)。把整套 9 道題目的處理時間加總比對,三款模型的推論耗時有明顯差異:
- Gemma4 12B Q8:
- 跑完 9 題總共只要 15.482 秒(圖表四捨五入標示 15.5 秒)
- Phi-4 Q8:
- 總共需要等待 24.863 秒(圖表標示 24.9 秒)
- Ministral3 14B Q8:
- 總共需要等待 25.996 秒(圖表標示 26.0 秒)
處理完全相同的 9 道繁中文件,Gemma4 12B 比另外兩款足足快了 10 秒鐘以上!雖然每道題目的長度與推論難度不同,不能單純除以 9 說每題固定只要 1.7 秒;但如果你的公司每天需要批次處理幾百份表單,這十幾秒的差距累積下來,就是好幾個小時的落差。
Q4 和 Q8 差多少?從Gemma 12B 實測看 GGUF 檔案大小與品質的真相
既然知道模型本身的特性差異很大,接下來我們鎖定表現最穩定的 Gemma4 12B 家族,一口氣實測 Q4、Q6 到 Q8 共六個版本,直接用數字回答大家最常問的:Q4 和 Q8 差多少?空間能省多少?答案品質會不會縮水?
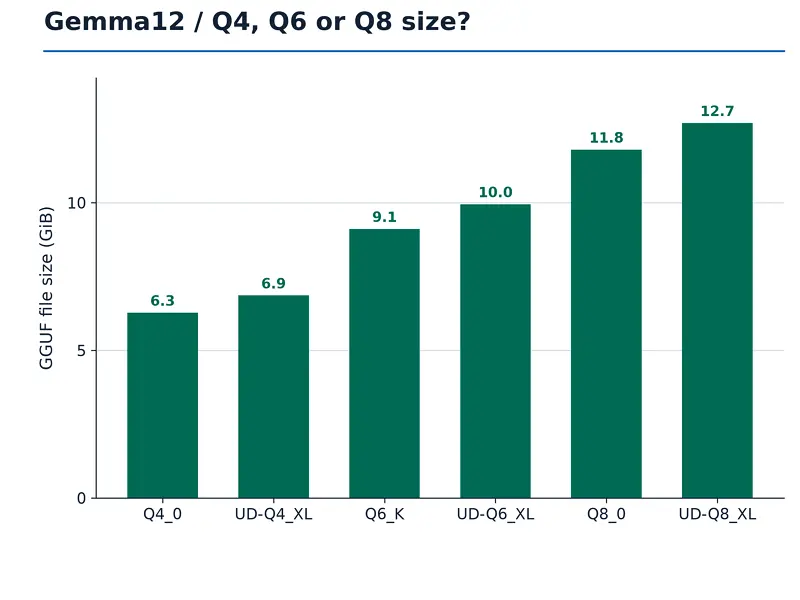
從圖 3 可以清楚看到六個測試模型的實際檔案大小:
- Q4_0(標準 4 位元)
- 6.276 GiB(平均每個參數佔用約 4.52 bits)
- UD-Q4_K_XL(動態最佳化 4 位元)
- 6.861 GiB(平均約 4.94 bits)
- Q6_K(標準 6 位元)
- 9.114 GiB(平均約 6.56 bits)
- UD-Q6_K_XL(動態最佳化 6 位元)
- 9.951 GiB(平均約 7.17 bits)
- Q8_0(標準 8 位元)
- 11.800 GiB(平均約 8.50 bits)
- UD-Q8_K_XL(動態最佳化 8 位元)
- 12.701 GiB(平均約 9.15 bits)
很多人好奇 UD-Q4_K_XL 與 Q4_0 差異 在哪裡?
【UD】代表量化團隊把比較敏感、重要的網路層保留較高精準度,其他層才壓縮,所以它的檔案比標準 Q4_0 大了約 0.58 GiB。
而若把 Q4_0 跟 Q8_0 相比,單一模型檔案就省下了 5.524 GiB(省下約 46.8% 容量),這對 SSD 儲存空間與顯示卡記憶體(VRAM)都是極大的減負。
但檔案變小了,GGUF 檔案大小與品質之間會不會呈現【越壓縮越笨】的關係?
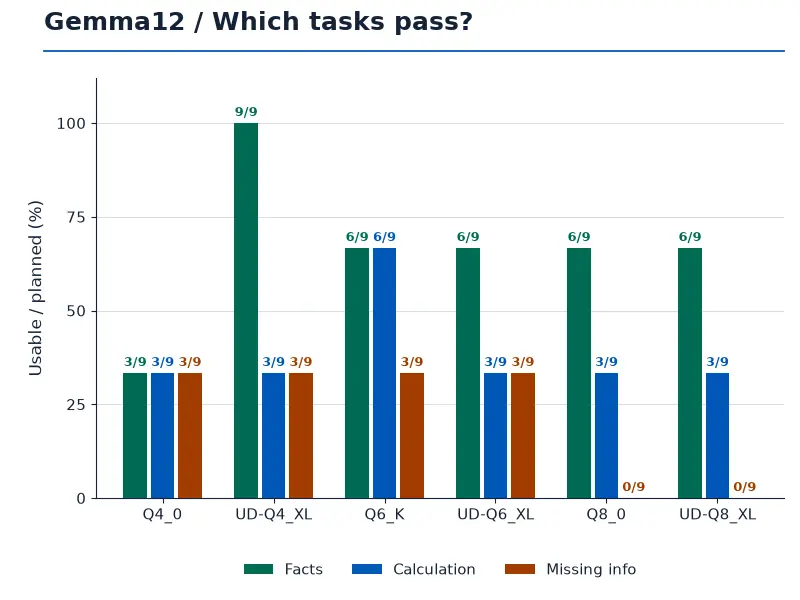
圖 4 把 Gemma4 12B 六個量化方案在三種文件題型(擷取、計算、未提供資訊判斷)的過關率,每種題型分母皆為 9 次排定作答,直接把三種工作題型拆開來看:
- 結論:
- 完全顛覆了【位數越高成績一定越好】的直覺
- 擷取核准資訊(Facts,綠色):
- UD-Q4_K_XL 竟然拿下 9/9(100%)滿分過關!
- 反觀 Q6 與 Q8 的四個版本都是 6/9(66.7%)。
- 而最精簡的標準 Q4_0 則是 3/9(33.3%)。
- 依文件計算與比較(Calculation,藍色):
- Q6_K 拿下最高的 6/9(66.7%)。
- 其餘五個版本(包含最高規的 Q8)通通只有 3/9(33.3%)。
- 判斷未提供的資訊(Missing info,橘色)
- Q4 與 Q6 的四個版本都拿下 3/9(33.3%)。
- 但 Q8_0 與 UD-Q8_K_XL 卻出現 0/9!
為什麼會這樣?因為公開下載的模型檔案沒有標註最上游的原始權重版本號(base revision),而且我們的客觀題是 9 道精選題目,所以絕對不能據此宣稱【Q4 普遍比 Q8 更聰明】。
但這張圖給了所有工作站採購者一個重要的提醒:別以為無腦衝 Q8 就能解決所有問題!在特定中文表格擷取任務上,經過動態調校的 UD-Q4_K_XL 或 Q6_K,反而比肥大的 Q8 更容易通過自動化檢驗。
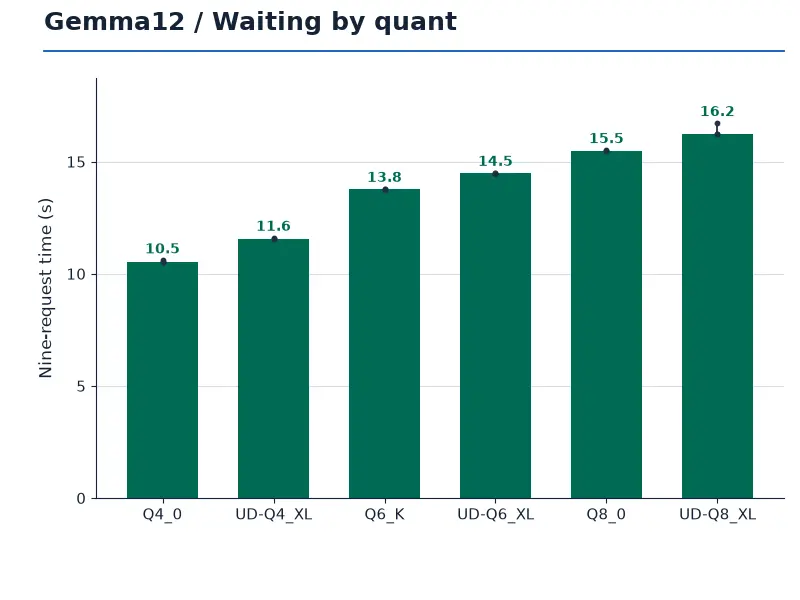
接著來看 Gemma4 12B Q4、Q8 速度到底差多少?圖 5 是 Gemma4 12B 六個量化方案在雙卡模式下,完成 9 道客觀題的總等待秒數中位數。在等待時間上,檔案大小與處理速度呈現非常明顯的正相關:
- Q4_0:
- 10.547 秒(10.5 秒)
- UD-Q4_K_XL:
- 11.557 秒(11.6 秒)
- Q6_K:
- 13.775 秒(13.8 秒)
- UD-Q6_K_XL:
- 14.486 秒(14.5 秒)
- Q8_0:
- 15.482 秒(15.5 秒)
- UD-Q8_K_XL:
- 16.223 秒(16.2 秒)
選 Q4_0 比選 Q8_0 每跑一輪 9 道題就能省下約 4.935 秒(快了超過三成)。
如果綜合圖 3、圖 4、圖 5 來看,UD-Q4_K_XL 與 Q6_K 在容量、過關率與等待時間之間取得了極佳的平衡,是日常部署 CP 值最高的選擇。
小模型 Q8 還是大 MoE 模型 Q4?揭開 GPU offload RAM/CPU 的代價
在論壇裡,常常看到大家吵成一團:在顯示卡記憶體預算有限的情況下,到底該選小一點的 Dense 模型跑高精度 Q8,還是挑 26B、30B 的 MoE(混合專家模型)壓到低精度 Q4?
與其做理論的爭論,不如直接把三款 12B~14B 的日常 Q8 模型,跟兩款熱門的 MoE 模型(Google Gemma4 26B-A4B 與 NVIDIA Nemotron3 Nano 30B-A3B 的 UD-Q4_K_XL 版本),直接丟進雙卡全力運作的環境(Requested 99)做實測。
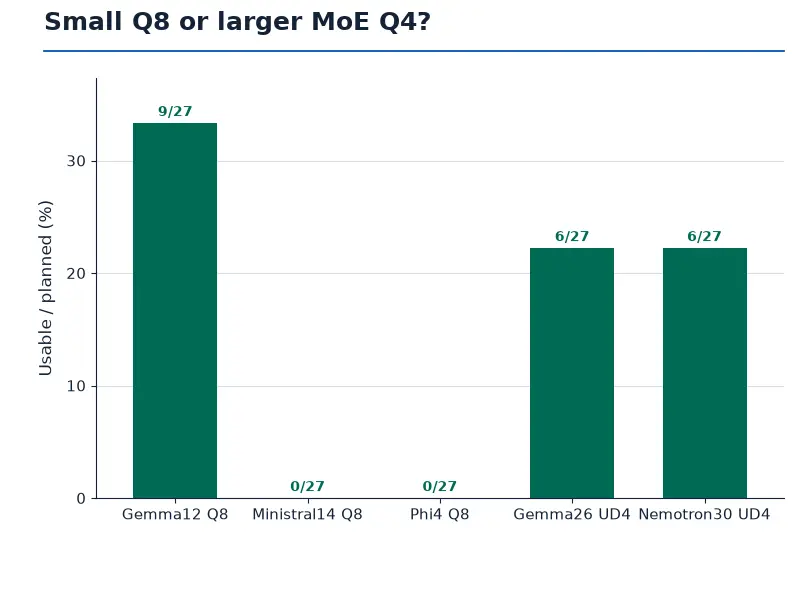
圖 6 是雙卡全上模式下,三款日常小模型 Q8 與兩款較大 MoE 模型 UD-Q4 的可用答案過關率比較(分母皆為 27 次排定作答)。直接看圖 6 的殘酷數據:
- 兩款掛著大參數光環的 MoE 模型(Gemma26 UD4 與 Nemotron30 UD4),在 27 次繁中考題中都只拿到 6 次過關
- 完全沒有因為參數總量標上 26B 或 30B 就輾壓全場。
- 反而是 12B 的 Gemma4 Q8 繳出 9/27(33.33%)的成績。
這就牽扯出大家在組裝工作站時最在意的核心問題:MoE需要多少顯存?
很多剛入坑的玩家看到模型標註 26B-A4B 或 30B-A3B,以為每次推論只會啟動 4B 或 3B 的專家活躍參數,就以為【那我只要準備能塞得下 4B 模型的顯示卡不就能順跑了?】
這絕對是天大的誤會! 活躍參數少只代表【算得快】,但這群專家全都在同一個模型檔案裡。開機載入時,全部 26B、30B 的權重一個字都少不了,通通得塞進 GPU 硬體裡!
當試著把 Nemotron3 30B 的高精度 Q8_0 版本(單一檔案就肥達 31.28 GiB)塞進雙卡 RTX 5060 Ti 16GB 跑全 GPU 模式時,顯示卡記憶體當場被塞爆,直接跳出 OOM(Out of Memory,記憶體不足崩潰),連第一題都還沒讀完就原地當掉!
這時候大家通常會退而求其次:既然顯示卡吃不下,那用 llama.cpp 把部分運算層丟回 CPU 和系統 RAM 來跑(Fixed 20 混合模式),這樣可行嗎?
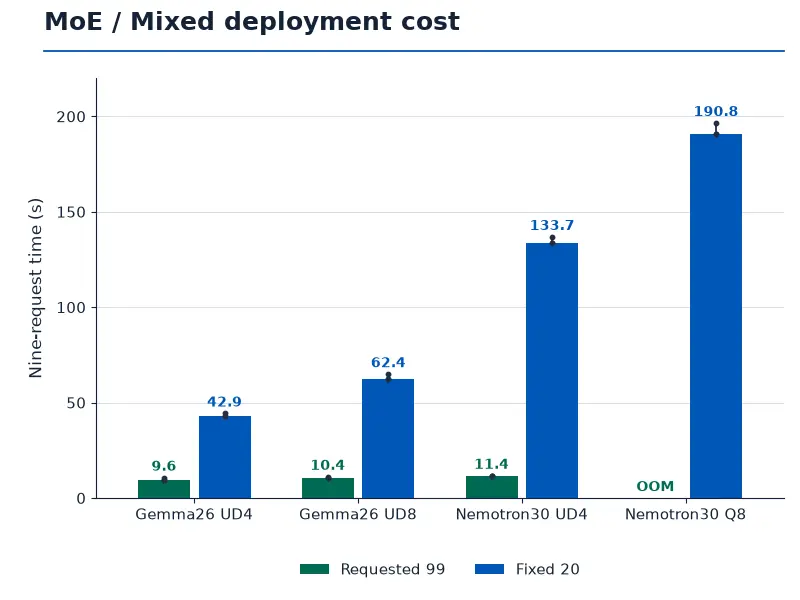
能跑是能跑,但來看看這個 GPU offload RAM/CPU 等待代價到底有多令人失望。圖 7 是四款 MoE 模型在全上顯示卡(Requested 99,綠柱)與混合部署(Fixed 20,藍柱)下的 9 題總等待時間。OOM 代表載入失敗無數據。
- Gemma26 UD-Q4:26B
- 全塞進顯示卡只要 9.552 秒。
- 但只要顯卡吃不下、退到 Fixed 20 混合部署,等待時間立刻暴增到 42.923 秒(足足慢了將近 4.5 倍)!
- Gemma26 UD-Q8:26B
- 全顯示卡只要 10.361 秒。
- 退到混合部署直接飆到 62.363 秒(整整慢了 6 倍,跑一輪要等超過一分鐘)!
- Nemotron30 UD-Q4:30B
- 全顯示卡只要輕鬆的 11.432 秒。
- 一旦顯卡裝不下被迫分流給 CPU,等待時間直接噴到 133.696 秒(慘烈暴增將近 12 倍)!
- Nemotron30 Q8:30B
- 在全上顯示卡模式直接 OOM 當機崩潰。
- 雖然退到 Fixed 20 混合模式靠著大容量 RAM 勉強救回來跑完,但處理這 9 道題目總共讓你乾等了 190.825 秒(超過 3 分鐘)!
當模型大到塞不進顯示卡 VRAM、必須 Offload RAM/CPU 來運算時,PCIe 匯流排的頻寬瓶頸會直接拖慢 AI 模型的表現。
除非系統是深夜放著沒人管的批次排程,否則千萬別為了盲目追求超大參數,而讓前端使用者對著轉圈圈的網頁發呆。
兩張 16GB 顯示卡不等於 32GB!升級AI工作站必看的 VRAM 與 RAM 配置
組裝雙卡工作站最常見的算盤就是:一張 RTX 5060 Ti 有 16GB,插兩張就有 32GB,怎麼可能塞不下 31.28 GiB 的 Nemotron30 Q8?
答案很簡單:兩張卡是各自獨立的實體硬體,根本不是能隨意打通的連續記憶體池! 系統桌面輸出、背景程式,加上推論不可或缺的 KV 快取,每一樣都在搶顯存。只要任何一張卡塞不下,系統就直接當機。
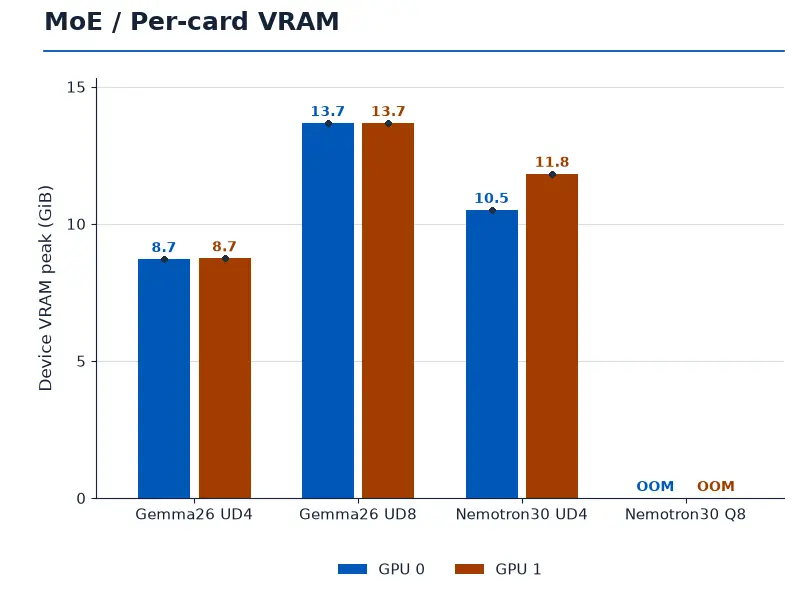
全上顯示卡模式下,GPU 0 與 GPU 1 兩張實體顯示卡各自記錄到的最高 VRAM 用量(包含系統背景程式)。實體分卡數據說明了一切:
- Gemma26 UD-Q4:
- GPU 0 吃到 8.715 GiB、GPU 1 吃到 8.746 GiB。
- 負載切得極為漂亮,離 15.93 GiB 上限還有 7 GiB 以上的安全緩衝。
- Gemma26 UD-Q8:
- GPU 0 衝到 13.678 GiB、GPU 1 來到 13.677 GiB。
- 兩張卡雙雙逼近極限,只剩 2.2 GiB 左右的餘裕。
- Nemotron30 UD-Q4:
- GPU 0 佔用 10.510 GiB、GPU 1 佔用 11.830 GiB。
- 兩張卡負載並不完全對稱。
- Nemotron30 Q8:
- 模型加快取直接頂破單卡上限。
- 載入階段直接 OOM 當機崩潰,完全無法運作。
這就是殘酷的硬體現實:算顯存絕對不能相加除以二! 每一張卡都必須獨立扛住分配到的層數與快取,實務上至少要預留 2~3 GiB 避免突發爆卡。
那退到 CPU 混合模式(Fixed 20)時,主機的系統記憶體(RAM)會不會直接被塞爆?
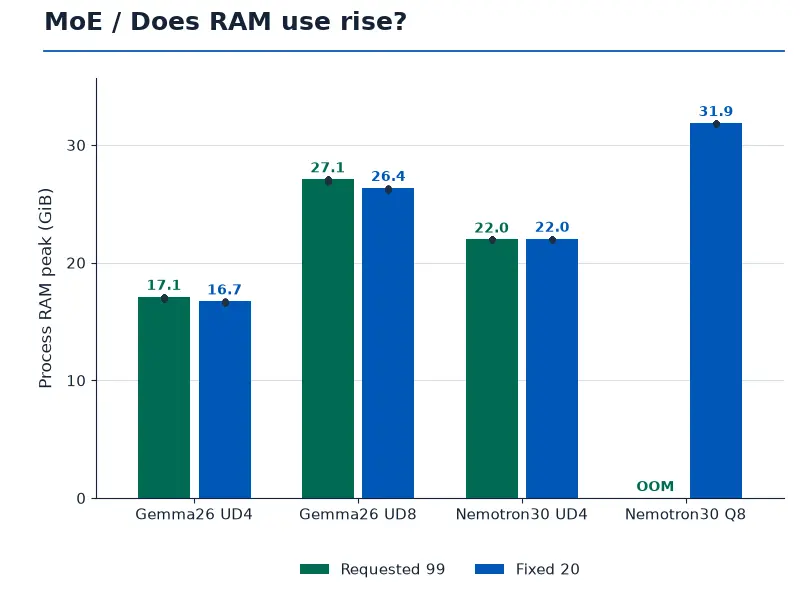
圖 9 是四款 MoE 模型在全顯卡與混合部署下,推論程式的實體記憶體工作集(Process RAM)峰值比較。監測結果完全打破直覺:
- Gemma26 UD-Q4:
- 全顯卡吃 17.103 GiB
- 混合模式反而降到 16.715 GiB
- Gemma26 UD-Q8:
- 全顯卡吃 27.091 GiB
- 混合模式為 26.353 GiB
- Nemotron30 UD-Q4:
- 全顯卡吃 21.973 GiB
- 混合模式為 22.042 GiB
- Nemotron30 Q8:
- 混合模式成功跑完,程序 RAM 來到 31.870 GiB。
為什麼丟給 CPU 跑,RAM 卻沒有翻倍?因為 llama.cpp 開啟了 mmap(Memory-Mapped),模型檔案本來就在虛擬記憶體定址裡,圖 9 抓到的是實際頻繁讀寫的工作集。
這再次證明:組裝百 GB 記憶體的工作站,混合模式最致命的從來不是 RAM 夠不夠裝,而是跨匯流排傳輸拖出的 133~190 秒可怕延遲!
答案明明算對卻拿零分?破解本地 AI JSON 輸出不穩定的自動化陷阱
在公司寫自動化 API 串接本地模型,最讓人崩潰的不是模型答錯,而是它明明算對了,程式一解析卻當場報錯噴例外!回到一開始圖 1 留下的最大懸案:為什麼在雙卡實測中,表現看似強悍的 Ministral3 14B Q8 與微軟 Phi-4 Q8,可用產率會直接掛出刺眼的 0/27?
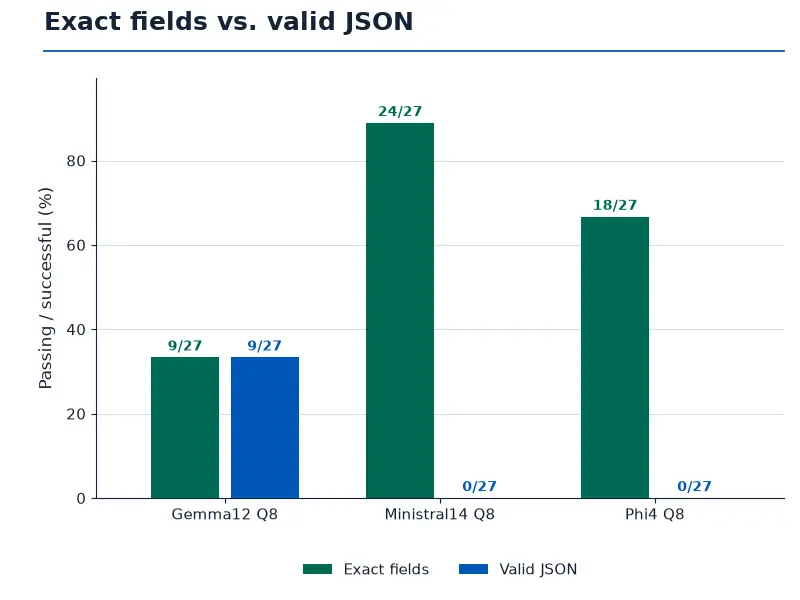
我們把評分紀錄拆開成【所有欄位內容完全正確(Exact fields)】與【純 JSON 格式合規(Valid JSON)】兩項指標,真相瞬間大白。圖 10 是三款日常 Q8 模型在 27 次成功客觀作答中,【欄位內容完全正確(綠柱)】與【純 JSON 格式合規(藍柱)】的獨立過關比率。
- Gemma4 12B Q8:
- 欄位內容全對是 9/27(33.33%)
- 純 JSON 格式合規也是 9/27(33.33%)
- Ministral3 14B Q8:
- 欄位內容全對竟然高達 24/27(88.89%,全場最高!)
- 但純 JSON 格式合規卻是 0/27
- Phi-4 Q8:
- 欄位內容全對也達到 18/27(66.67%)
- 但純 JSON 格式合規同樣是 0/27
為什麼內容準確度逼近九成,系統格式卻被判定全軍覆沒?
因為 Ministral 14B 與 Phi-4 的 27 次客觀作答,全部都用包含反引號的 Markdown 程式碼區塊(即 json … )把答案包起來,完全違反了自動化系統【只能輸出純 JSON】的硬性規定!這段實測血淚史,精準點破了許多開發者在做自動化串接時,最常遇到的本地 AI JSON 輸出不穩定與 LLM 欄位答對 JSON 格式錯誤痛點:
- 中文理解力強,不代表能直接串接 API:
- 模型本身的繁中合約與報價單理解計算能力極強
- 但只要它自作主張多包一層外框符號,後端程式若直接丟進標準 json.loads() 解析,系統就會當場拋出例外報錯、整條自動化產線直接停擺。
- 嚴守客觀實測界線:
- 不能只憑這輪題目就斷言這兩款模型永遠改不掉帶外框的習慣
- 也不能宣稱去掉外框就保證全部過關
- 這項結論受限於當前的提示詞與測試設定
- 給系統架構師最明確的提醒:本地 LLM 絕對不能只看模型聰不聰明,一定要在接收端設計防禦性程式碼(先過濾外框),或搭配推論引擎嚴格的結構化語法約束,才能打造真正穩定可商用的自動化流程!
四種實務情境幫你找到高 CP 值方案
高 CP 值本地 AI 挑選軟硬體四步驟:
- 確認顯示卡 VRAM 裝得下 (避開 OOM 當機)
- 驗證公司考題與 JSON 格式 (確保系統接得上)
- 評估批次等待秒數 (避開慢速混合模式)
- 預留單卡安全空間 (確保長期穩定)
硬碟與顯示卡記憶體有限(預算先決 / 單卡或入門雙卡環境)
如果手邊的 SSD 容量或顯示卡 VRAM 比較吃緊,不需要硬衝肥大的 Q8。從圖 3 到圖 5 可以看到,同家族的 Gemma4 12B UD-Q4_K_XL(6.86 GiB)或 Q6_K(9.11 GiB)就能省下大量空間,且在本輪擷取與計算題型的過關率甚至不輸 Q8,是兼顧硬體成本與任務產出的高 CP 值起點。
追求高效率與低延遲(每天有大量文件要批次處理)
時間就是金錢!如果你的流程很看重反應速度,請優先選擇能完整塞進顯示卡 VRAM 裡(如 Requested 99 模式)的方案。Gemma12 的 Q4/Q6(10.5~13.8 秒)或全上顯示卡的 Gemma26 UD-Q4(9.6 秒)都非常俐落;千千萬萬不要為了用大參數模型而硬開 Fixed 20 混合部署,否則動輒 42 秒到 190 秒的等待時間會讓你的自動化流程徹底卡死。
嚴格的自動化系統與資料庫串接(純 JSON 介面優先)
如果後端系統是直接讀取 AI 輸出、沒有寫額外的外框清洗程式,那像 Gemma4 12B 這種能乖乖遵守純 JSON 格式的模型會讓你省心很多。反過來說,如果你非常需要使用 Ministral3 14B 高達 24/27(88.9%)的超強欄位正確率,請務必在接收端加上一道自動剝除程式碼外框的處理程序,或是測試開啟推論引擎的結構化語法限制功能。
需要處理長篇中文摘要(SUMMARY 任務)
針對長篇文件的摘要整理,本輪雖然已經完成了時間與格式的自動記錄,但因為還沒有經過人工逐字核對事實正確性與完整度,我們不隨便宣稱哪一款摘要品質最好。建議有摘要需求的團隊,先用這份報告篩選出速度與顯存合格的模型,再拿公司內部真實的公文做小規模人工盲測。
GGUF 量化怎麼選?常見問題 FAQ
Q1:處理繁體中文採購與維運文件,選 Q8 一定比 Q4 更準嗎?
A1:不一定!
從我們圖 4 的實測可以看到,Gemma4 12B 的 UD-Q4_K_XL 在資訊擷取題拿到 9/9 滿分,Q6_K 在計算題拿到 6/9,表現反而比同家族的 Q8_0 更亮眼。位數高低不代表特定任務一定過關,還是要看實際考題與格式表現。
Q2:為什麼 Ministral 14B 和 Phi-4 在圖 1 的可用答案拿到 0/27?
A2:因為它們在全部 27 次作答中,都在 JSON 答案外面多包了一層程式碼區塊外框,違反了系統【只能輸出純 JSON】的規定。如果把外框拿掉單看裡面的欄位內容,Ministral 其實答對了 24/27(88.9%),Phi-4 也答對了 18/27(66.7%),本身的繁中理解力非常強。
Q3:如果模型愛包程式碼外框,開啟 JSON Schema 強制約束能修好嗎?
A3:llama.cpp 等推論引擎確實有提供 --json-schema 或 grammar 強制約束功能,或者也能在後端寫程式把外框濾掉。不過本輪測試的目的是檢驗模型的原生輸出表現,並未額外測試開啟強制約束後的過關率與速度變化,建議在實際系統上線前先做對照測試。
Q4:MoE 模型標示 30B-A3B,是不是代表只要 3B 大小的顯示卡記憶體就能跑?
A4:完全不是!
A3B 只代表每次生成文字時【動用 3B 的活躍參數去計算】,但整座模型全部 30B 的專家權重都必須載入記憶體裡待命。像 Nemotron 30B Q8 檔案高達 31.28 GiB,在雙卡 5060 Ti 全開模式下照樣會塞爆顯示卡記憶體(OOM)而當掉。
Q5:Fixed 20 混合模式,是指只用 CPU 跑嗎?
A5:不是。
Fixed 20 是我們預先排定的「雙顯示卡+CPU+系統 RAM」混合部署模式,固定把 20 層權重放在兩張 RTX 5060 Ti 顯示卡上,其餘層數交給 CPU 和主機記憶體處理,用來測試當顯示卡裝不下整顆模型時,退而求其次的真實速度代價。
Q6:電腦插了兩張 16GB 顯示卡,為什麼不能當成一張 32GB 顯示卡來用?
A6:因為兩張實體顯示卡的記憶體是分開獨立管理的(GPU 0 與 GPU 1),並不是一個連續的 32GB 大水池。除了模型權重無法百分之百完美平分之外,顯示卡還要放上下文快取(KV Cache)與系統背景程式,只要其中一張卡超載就會當掉。
Q7:把更多模型層數丟給 CPU 跑(Fixed 20),為什麼主機 RAM 用量沒有暴增?
A7:因為在開啟 mmap 的情況下,模型檔案已經透過作業系統映射在虛擬記憶體中,圖 9 記錄的是該程序在請求期間的【工作集峰值(Process Working Set Peak)】,並非把整個模型硬生生複製一份塞進實體 RAM,所以數值不會照直覺大幅飆高。
AI 文章延伸閱讀
ChatGPT 最佳替代方案:AnythingLLM 自架教學
Windows 11 本地 AI 助理架設指南
OpenAI Whisper:影片字幕自動生成教學
打造離線版 AI 會議記錄與摘要神器
雙16GB 顯卡能當32GB 跑?雙卡16GB 地端LLM 實測,打破顯存相加迷思
32GB VRAM Local LLM?RTX 5060 Ti 多卡Windows 教學
拒當白老鼠!訂閱Google AI Pro 作為程式開發的5 大踩雷實錄
16GB GPU 天花板?Llama 3 8B 與熱門8B GGUF 模型效能實測
GGUF 量化怎麼選?選對硬體配置打造高 CP 值本地 AI 工作站
評估 GGUF 量化怎麼選,關鍵在於先確認顯示卡 VRAM 裝得下以避開當機,再拿真實繁中文件實測內容與純 JSON 相容性,並在合理等待時間內預留餘裕,才能打造穩定、高 CP 值的雙卡 RTX 5060 Ti 16GB 解法。
📚 Local AI 本地部署 系列
← Local AI 本地部署指南:Ollama、AnythingLLM、Whisper