玩本地端大語言模型的硬體玩家,通常在把顯示卡與記憶體撐滿後,下一個念頭就會動到儲存裝置上:既然 Gemma 4 26B 這類高品質模型動不動就是 25 GiB 起跳,如果把多支 PCIe 5.0 SSD 組成 NVMe RAID 0,循序讀取頻寬翻倍,模型載入速度是不是就能跟著砍半?
為了不靠猜測,我直接在雙顯示卡工作站上啟用 Intel VROC,分別將 1 到 4 顆的 NVMe SSD 與企業級 SATA HDD 組成 RAID 0,在每次【重新開機後冷載入】的條件下,實測本地 AI 模型載入速度與整題回答完成時間,跑出來的結果跟多數人想像的完全不同。
NVMe RAID 0 對本地 AI 模型載入速度的真實影響
在評估硬碟陣列能不能幫推論提速之前,我們得先看清楚 llama.cpp 載入 GGUF 模型時,系統資源究竟卡在哪個環節。當我們啟動本地推論服務並開啟 mmap=true(記憶體映射)時,作業系統並不是單純把檔案【搬進】記憶體就完工了,背後還牽涉到分頁表建立、張量分配、將指定層數(本輪固定 n_gpu_layers=20)傳輸進雙顯示卡 VRAM,以及多執行緒初始化等一連串動作。
這代表【模型就緒時間(Ready Time)】是由磁碟 I/O 讀取與 CPU 記憶體映射處理共同決定的。只要單顆硬碟的循序讀取頻寬已經超過 CPU 處理分頁錯誤(Page Faults)的消化速度,就算你把 NVMe RAID 0 的理論頻寬疊到破萬 MB/s,實際體感依然會撞上同一道天花板。這與我們先前分析 PCIe 5.0 SSD 實際體感速度受限的底層原因完全吻合,也是影響 本地 AI 模型載入速度 最關鍵的瓶頸。
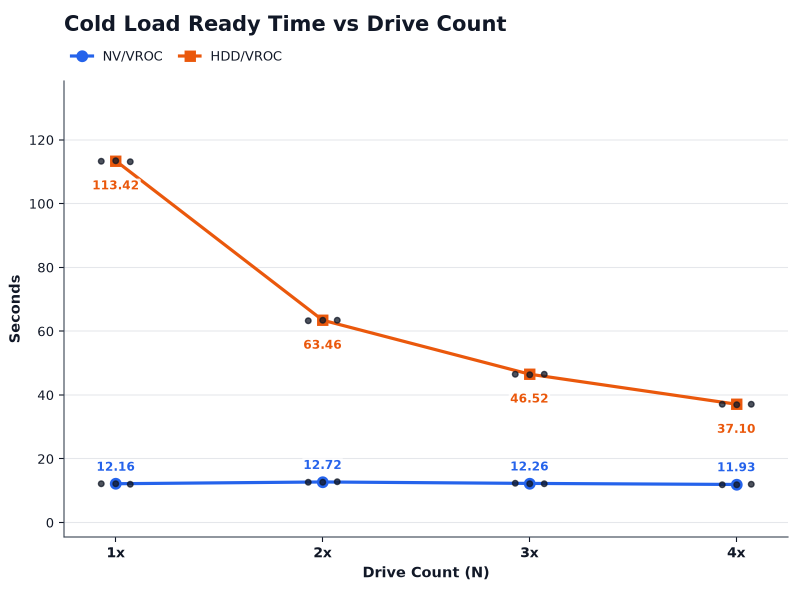
直接看圖 1 的冷載入就緒曲線最直觀:
- 橘線:
- 代表的傳統機械硬碟(HDD/VROC)從 1 顆加到 4 顆一路陡降
- 藍線:
- 代表的 NVMe 陣列(NV/VROC)幾乎是一條死魚般的水平線
- 單支原生 NVMe 載入 25.02 GiB 的 Gemma-4-26B-A4B-IT Q8_0 只要 12.16 秒(樣本區間 12.15–12.27 秒)
- 組了 4 支 VROC 陣列之後依然要 11.93 秒(11.87–12.10 秒),前後差距僅有 0.23 秒
測試工作站硬體與儲存陣列規格
為了排除 Windows 檔案系統快取造成的假象,所有【冷載入(Cold Load)】測試都在工作站完整重新開機、核心啟動約 70 秒後立刻執行,確保程式啟動前沒有任何 GGUF 檔案預讀快取。關於這套雙卡主機的組裝細節,可參考雙卡 RTX 5060 Ti 16GB 打造 32GB VRAM 本地工作站實戰:
| 品名 | 型號/規格 |
|---|---|
| 工作站系統 | SuperWorkstation SYS-551A-T |
| CPU | Intel Xeon W5-3425 |
| 主機板 | Supermicro X13SWA-TF |
| 記憶體 | 32GB DDR5-4800 ECC RDIMM *2 |
| GPU | 雙卡 Nvidia GeForce RTX 5060 Ti 16GB |
| Gen5 NVMe | 4 支 Kingston FURY Renegade G5 1TB |
| SATA HDD | WD Gold 10TB 3.5吋金標企業級硬碟 |
| 作業系統 | Windows 11 專業版 |
| 推論引擎與參數 | llama.cpp(ctx_size=2048、n_gpu_layers=20、batch_size=512、ubatch_size=128、mmap=true、flash_attention=on`、關閉思考模式) |
網路迷思破解:載入更快,第一段文字與熱重載也有幫助嗎?
許多玩家在規劃工作站儲存配置建議時,常會把【模型載入完成】跟【畫面吐出第一個字】混為一談,甚至誤以為每次重啟推論服務都能享受陣列加速。我們直接把整個請求的時間軸拆開檢視。
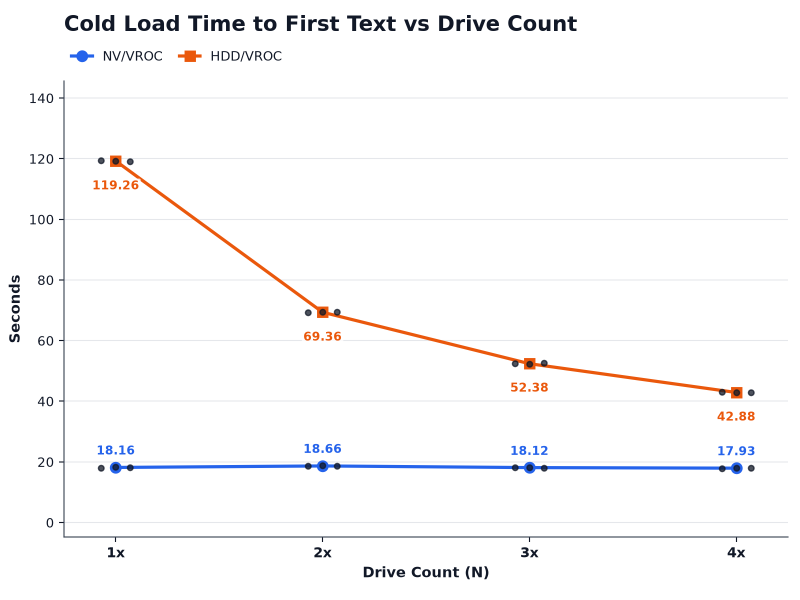
在圖 2 中,這項指標衡量的是【從啟動引擎、載入模型到輸出第一段非空文字(Startup to First Text)】的總耗時。
- NVMe 組從 1x 的 18.16 秒 到 4x 的 17.93 秒 幾乎沒有變動
- HDD 組則從 119.26 秒 縮短到 42.88 秒
原因在於模型載入就緒後,系統還必須花費約 5.71 至 6.10 秒 進行 504 個輸入 Token 的 Prefill(提示詞預處理)。這段運算完全吃的是雙卡 RTX 5060 Ti 16GB 與 Intel Xeon W5-3425 的算力,硬碟從模型就緒那一刻起讀取量就已經歸零,再快的陣列也幫不上忙。
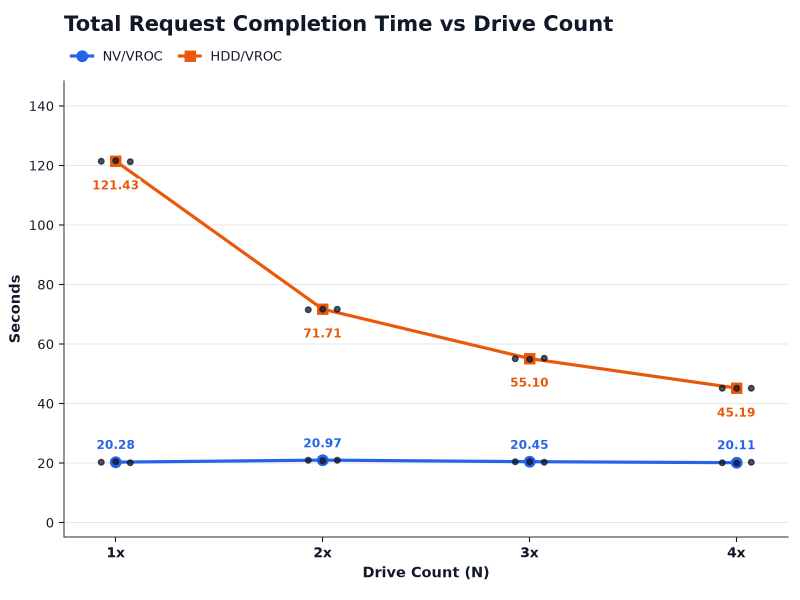
接著看圖 3,這是包含整題生成完畢(輸出 74 個 Tokens,約 2.05 至 2.36 秒生成時間)的端到端總耗時。
- NVMe 組不論插 1 支還是 4 支,總完成時間全部落在 20.11 到 20.97 秒 之間
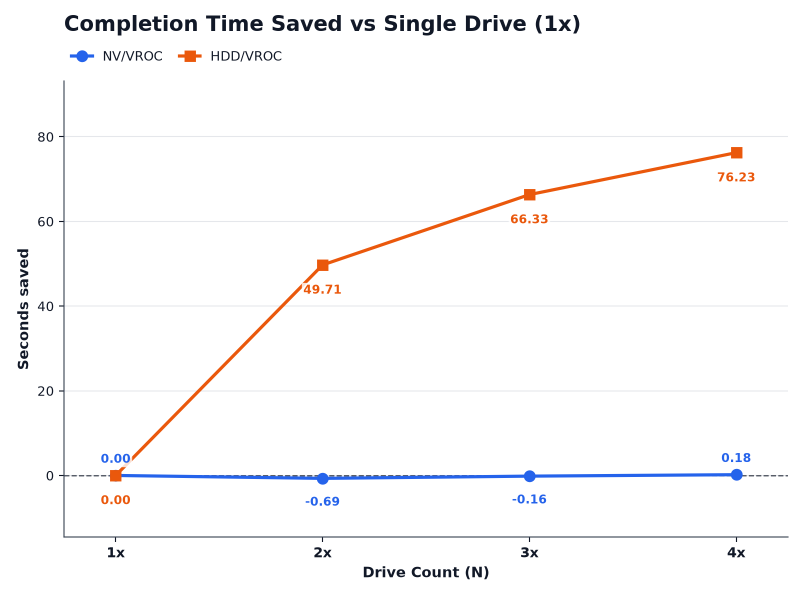
- 而 4 顆 HDD 組 RAID 0 後,總時間則從單顆的 121.43 秒 壓進 45.19 秒
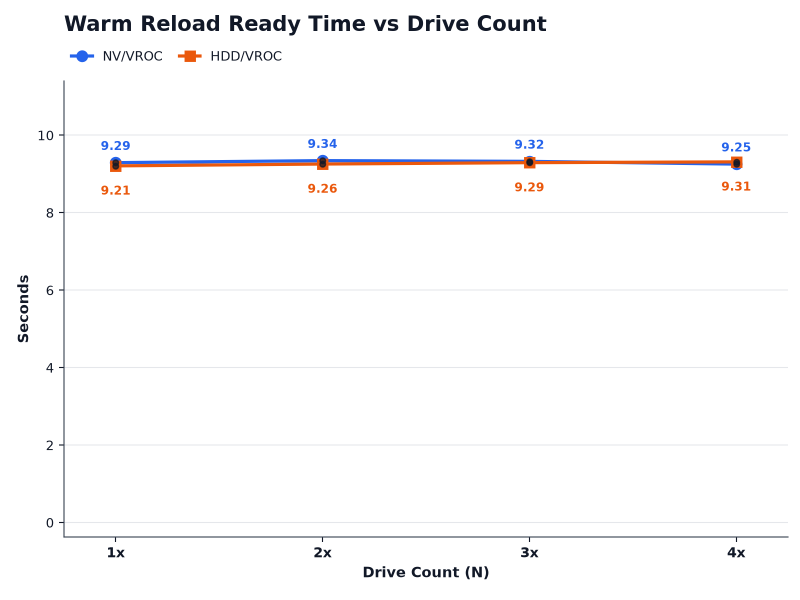
更貼近日常開發的場景在圖 4:當工作站不關機,只是切換模型或重啟 llama.cpp 服務(Warm Reload 熱重載)時,只要 128GB DDR5 記憶體還有餘裕,Windows 就會把剛剛讀過的 25.02 GiB 模型檔案留在記憶體快取(Standby List)裡。
此時不論底層是 1 顆還是 4 顆 NVMe,甚至是最慢的單顆機械硬碟,熱重載就緒時間全部落在 9.21 到 9.34 秒 之間,兩條線完全貼合。只要系統沒重開機、快取沒被擠掉,陣列的加速效果就是零。
NVMe RAID 0 與企業級硬碟陣列效能完整數據大對決
為了讓大家在手機與桌機上都能輕鬆對照硬體升級的投資報酬率,我將這份 NVMe RAID 0 實測 與 企業級硬碟陣列效能 數據,以 Gemma-4-26B-A4B-IT Q8_0(檔案實體大小 25.02 GiB,實測磁碟讀取總量約 26.86 GB)的中位數(Median)與最小/最大值範圍(Min–Max),拆分為兩張獨立的精簡對照表。
表 1:NVMe SSD 陣列冷載入與完成時間實測(Gemma 4 26B Q8_0)
| 硬碟配置 | 冷載入就緒 / 首段文字 | 整題完成 / 省時效益 |
|---|---|---|
| NV/VROC 1x 1 支原生 NVMe SSD | 12.16 秒(12.15–12.27) 首字:18.16 秒(17.95–18.27) | 20.28 秒(20.22–20.48) 基準值(1.00x) |
| NV/VROC 2x 2 支 NVMe VROC RAID 0 | 12.72 秒(12.66–12.82) 首字:18.66 秒(18.66–18.78) | 20.97 秒(20.85–21.02) 變慢 0.69 秒(0.97x) |
| NV/VROC 3x 3 支 NVMe VROC RAID 0 | 12.26 秒(12.22–12.34) 首字:18.12 秒(17.99–18.13) | 20.45 秒(20.32–20.47) 變慢 0.16 秒(0.99x) |
| NV/VROC 4x 4 支 NVMe VROC RAID 0 | 11.93 秒(11.87–12.10) 首字:17.93 秒(17.75–18.02) | 20.11 秒(19.99–20.38) 省 0.18 秒(1.01x) |
從表 1 可以清楚看見,原本把模型放在單支 NVMe SSD 上,多花錢買第 2 支、第 3 支 SSD 組 NVMe RAID 0,實際省下的秒數分別是 -0.69 秒 與 -0.16 秒;加到 2 支甚至比單支原生直連還要慢 0.69 秒。
這是因為經過 VROC 磁碟區管理層與 128 KiB 條帶切分(Striping)的排程開銷,在單一檔案連續大區塊 mmap 讀取下,反而抵銷了微小的頻寬優勢(關於條帶大小調整細節,可見 Intel VROC 陣列最佳 Strip Size 實測報告)。
表 2:WD Gold 10TB 企業級 HDD 陣列冷載入與完成時間實測(Gemma 4 26B Q8_0)
| 硬碟配置 | 冷載入就緒 / 首段文字 | 整題完成 / 省時效益 |
|---|---|---|
| HDD/VROC 1x 1 顆 WD Gold 10TB HDD | 113.42 秒(113.26–113.47) 首字:119.26 秒(119.08–119.35) | 121.43 秒(121.38–121.60) 基準值(1.00x) |
| HDD/VROC 2x 2 顆 HDD VROC RAID 0 | 63.46 秒 首字:69.36 秒 | 71.71 秒 省 49.71 秒(1.69x) |
| HDD/VROC 3x 3 顆 HDD VROC RAID 0 | 46.52 秒 首字:52.38 秒 | 55.10 秒 省 66.33 秒(2.20x) |
| HDD/VROC 4x 4 顆 HDD VROC RAID 0 | 37.10 秒 首字:42.88 秒 | 45.19 秒 省 76.23 秒(2.69x) |
反觀表 2 的企業級機械硬碟組,由於單顆 WD Gold 10TB 循序讀取大約只有 230–250 MB/s,組成 RAID 0 後直接突破了硬碟本身的物理頻寬限制,2 顆就省下 49.71 秒,4 顆更一口氣省下 76.23 秒,整題完成時間從超過兩分鐘壓進 45 秒出頭。
雙顯示卡推論記憶體需求與資源邊界實測
在規劃 雙顯示卡推論記憶體需求 時,必須嚴格區分【模型檔案大小】、【程序 RAM 工作集】與【顯示卡 VRAM 峰值】,避免發生顯存不足(OOM)導致服務崩潰(想了解不同量化等級的 VRAM 佔用差異,可延伸閱讀 雙 RTX 5060 Ti 測試 GGUF Q4/Q6/Q8 量化實測):
- 模型檔案實體大小:25.02 GiB(
Gemma-4-26B-A4B-IT Q8_0) - 顯示卡 NVML 顯存峰值:GPU 0 穩定佔用 9.21 GiB,GPU 1 佔用 8.70–8.73 GiB
- 雙張 RTX 5060 Ti 16GB 合計佔用約 17.91–17.94 GiB,完全未觸及 OOM 邊界
- 推論程序 RAM 工作集峰值(Process RSS):
- NVMe 組維持在 24.60 GiB,HDD 組維持在 24.36 GiB,整機系統已用記憶體峰值約 32.13–32.50 GiB
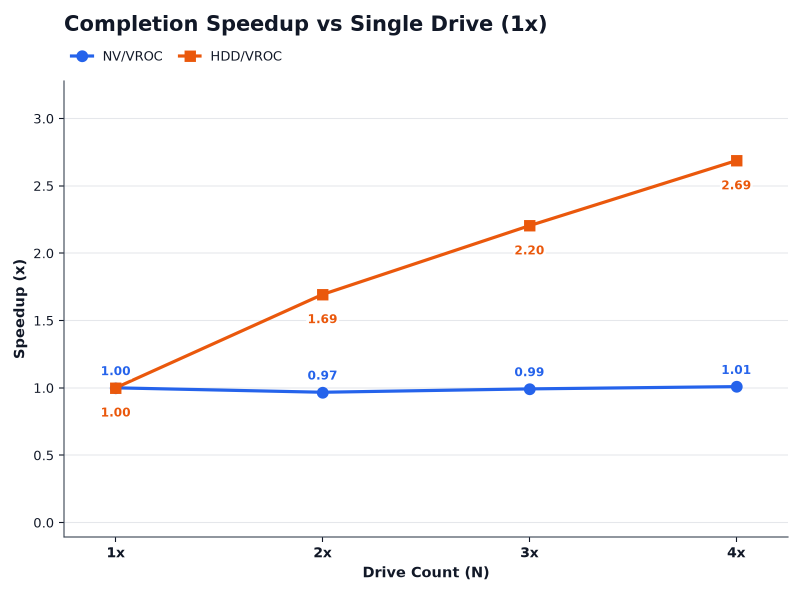
從圖 5 的加速倍率曲線能清楚看見兩者差異:
- HDD 組 2 顆帶來 1.69 倍 加速,3 顆來到 2.20 倍,4 顆達到 2.69 倍
- 反觀單支 PCIe NVMe SSD 本身就有數千 MB/s 的實力,載入 25 GiB 檔案時真正的瓶頸已經變成 CPU 處理
mmap分頁錯誤(約 653 萬次 Page Faults)與寫入記憶體的速率,所以即便疊到 4 支,加速倍率也只有 1.01 倍
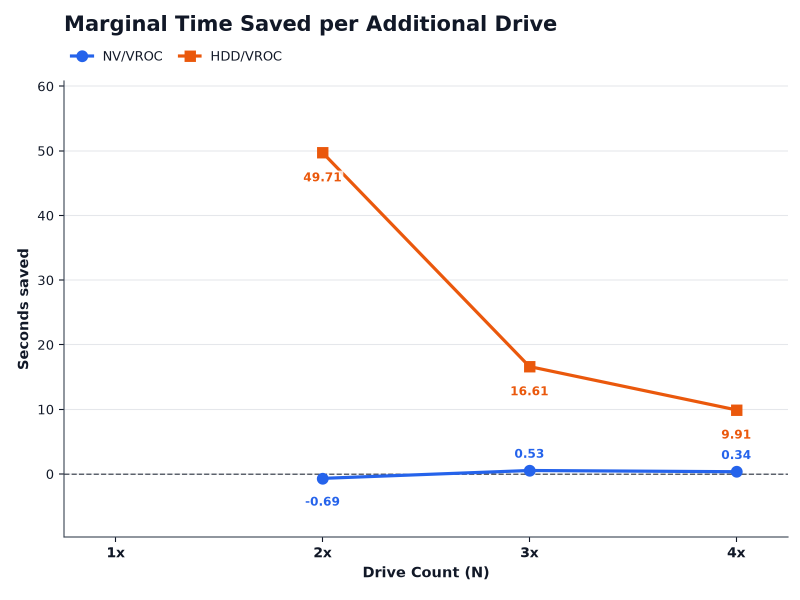
搭配圖 6 與圖 7 的【每增加一顆硬碟的邊際效益】來看,即使是收益最明顯的 HDD 陣列,也呈現典型的邊際遞減:
- HDD:
- 從 1 顆變 2 顆,這第 2 顆硬碟幫你省了 49.71 秒
- 再加第 3 顆,只多省 16.61 秒
- 加到第 4 顆,邊際省時只剩下 9.91 秒
實戰避坑與工作站儲存配置建議:多模型對比與選購指南
在拍板 工作站儲存配置建議 之前,很多人會問:【如果換成參數量較小的模型,結果會不會逆轉?】
我同時比對了 Gemma 12B 與 Gemma 26B 在 VROC NVMe 1x 至 4x 的實測表現(完整雙卡推論效能可參考 雙 RTX 5060 Ti 16GB 實測 Gemma 4 系列模型基準)。
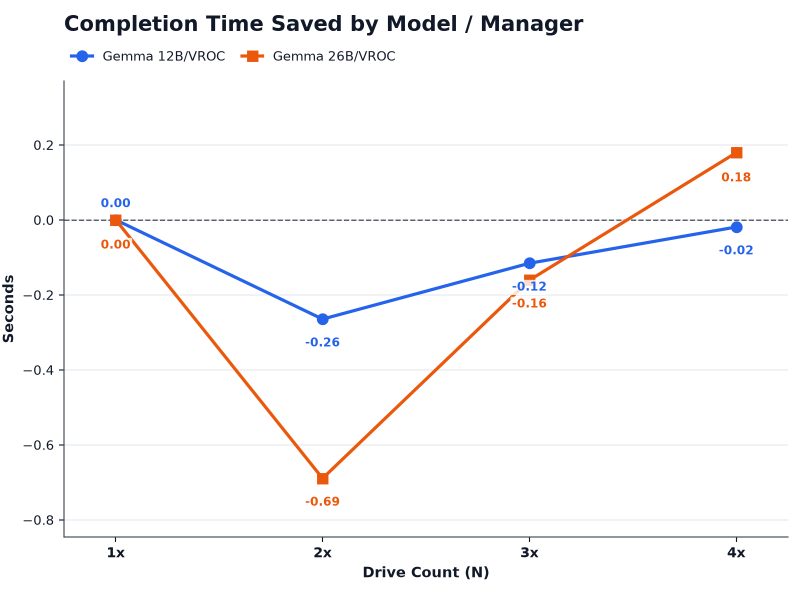
從圖 8 可以看到,檔案較小的 Gemma 12B 在 2 顆 NVMe 陣列下同樣出現 -0.26 秒 的負收益,3 顆為 -0.12 秒,4 顆也僅為 -0.02 秒(幾乎零變化)。兩款模型的折線走勢高度一致,都在 2x 處往下掉出負值,證明這不是單一模型的特例,而是作業系統與陣列架構的物理特性。
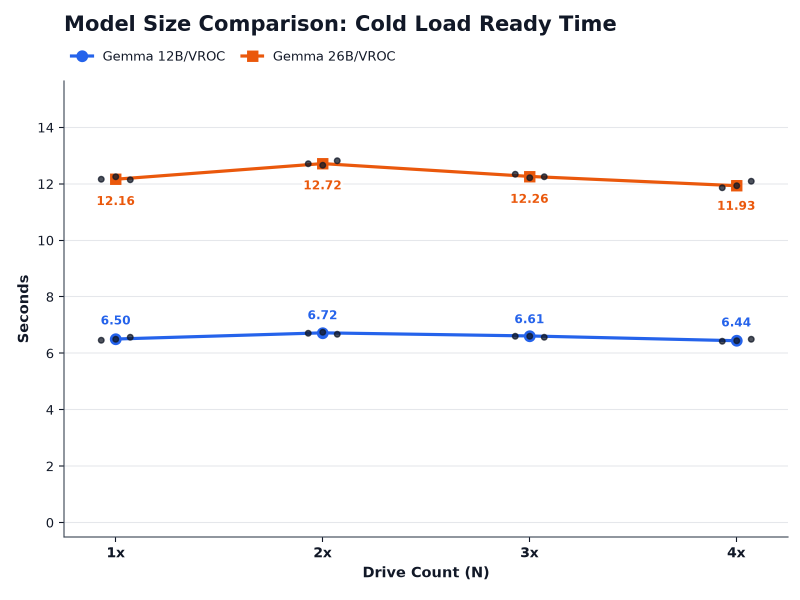
在圖 9 中,Gemma 12B 的冷載入就緒時間穩定維持在 6.44 至 6.72 秒,而 Gemma 26B 則維持在 11.93 至 12.72 秒。模型參數規模翻倍、檔案大小翻倍,載入時間確實等比例拉長,但【增加 NVMe 碟數】對兩者都無法產生有效的縮短效果。
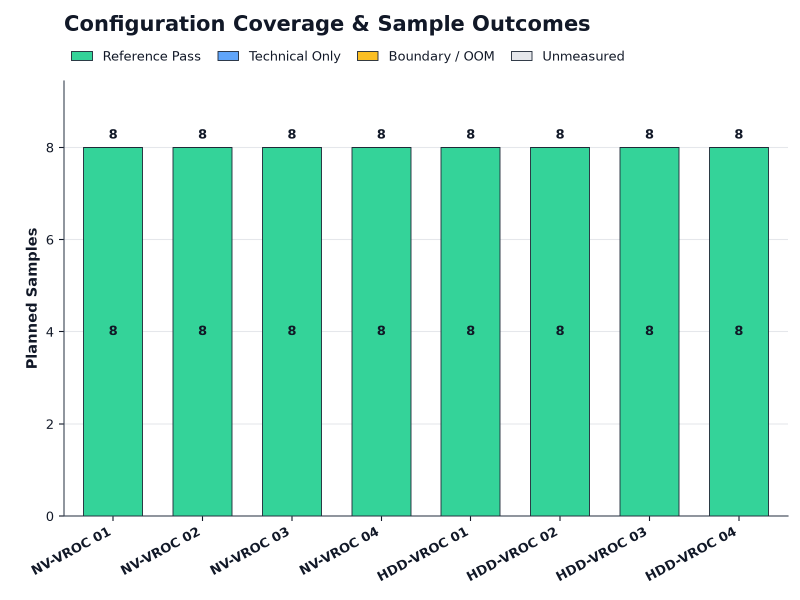
為了確保這份數據具備高度可信度,圖 10 呈現了本輪 8 組配置(NV-VROC 01~04 與 HDD-VROC 01~04)的樣本完整度:每組配置 8 個規劃樣本全部順利完成,且格式與引用驗證(Reference Pass)達成率皆為 100%,沒有任何異常樣本被隱匿。
給本地 AI 玩家的 4 個採購避坑重點
- 已經使用 PCIe Gen4 / Gen5 NVMe 的玩家,不要為了 AI 載入組 RAID 0:
- 單支原生 NVMe 的冷載入就緒時間(12.16 秒)已經貼近 CPU 處理
mmap的極限。 - 多買第 2 支組 NVMe RAID 0 不但沒變快,還多了 0.69 秒 陣列開銷,更省下額外購買硬體金鑰的成本(詳見 Intel VROC Key 值得買嗎?NVMe RAID 實測分析)。
- 如果你只是想把多顆 SSD 合併成單一大容量磁碟區方便管理模型,改用免額外硬體授權的 Windows 內建方案即可(可參考 Windows Storage Spaces 簡單磁碟區載入本地 AI 模型實測)。
- 單支原生 NVMe 的冷載入就緒時間(12.16 秒)已經貼近 CPU 處理
- 把硬體預算優先投資在「加大系統 RAM」:
- 只要主機板記憶體容量充足(例如 128GB 以上 DDR5),模型載入一次之後就會留在 Windows 記憶體快取中,後續熱重載只要 9.25 秒 左右,完全不吃硬碟頻寬。
- 冷門大模型倉庫碟(HDD)組 2 顆或 3 顆 RAID 0 最划算:
- 如果有數 TB 的冷門模型庫必須存放在傳統企業級 HDD,組 2 顆 RAID 0 就能把 25 GiB 模型的冷載入從 113.42 秒砍到 63.46 秒,直接省下將近 50 秒。
- 超過 3 顆之後邊際效益大幅衰減,把多出來的硬碟拿去做資料備份更實際。
- 單支大容量高速 NVMe 才是主力系統盤首選:
- 與其買多支小容量 SSD 組陣列,不如直接入手單支 2TB 或 4TB 的主流高速 NVMe SSD 存放常用 GGUF 模型,冷啟動 12 秒、熱啟動 9 秒的表現,已經遠勝 4 顆企業級 HDD 組成的 RAID 0(冷啟動 37.10 秒)。
常見問題 FAQ:NVMe RAID 0 與本地 AI 模型載入
Q1:用多支 NVMe SSD 組 RAID 0,跑本地 AI 模型的載入速度會變快嗎?
幾乎不會。實測載入 25.02 GiB 的 Gemma 4 26B Q8_0 模型時,單支原生 NVMe 冷載入就緒為 12.16 秒,組 4 支 Intel VROC 陣列為 11.93 秒,僅差 0.23 秒;組 2 支時甚至微幅變慢到 12.72 秒。
Q2:為什麼 NVMe 陣列循序讀取頻寬翻倍,載入 GGUF 模型卻沒有變快?
因為 llama.cpp 透過 mmap 載入模型時,瓶頸不在於 SSD 的讀取頻寬,而在於 CPU 處理數百萬次分頁錯誤(Page Faults)、建立記憶體映射表,以及將模型層搬移到顯示卡 VRAM 的處理速度。
Q3:傳統機械硬碟(HDD)組 RAID 0 對本地 AI 模型載入有幫助嗎?
非常有效。單顆 10TB 企業級 HDD 冷載入 25.02 GiB 模型需要 113.42 秒,組 2 顆 RAID 0 可縮短至 63.46 秒,3 顆縮短至 46.52 秒,4 顆縮短至 37.10 秒,整題完成最多可省下 76.23 秒。
Q4:HDD 組 RAID 0 幾顆的性價比最高?
2 顆到 3 顆的甜蜜點最高。從 1 顆加到 2 顆可省下 49.71 秒,加到第 3 顆可再省 16.61 秒,但加到第 4 顆的邊際省時效益已降至 9.91 秒,再往上疊加的效益有限。
Q5:模型已經載入過一次之後(熱重載),硬碟陣列還能加速嗎?
完全沒有幫助。實測顯示,在系統未重開機且記憶體快取充足的情況下,無論是 1x~4x NVMe 還是 1x~4x HDD,熱重載就緒時間全部落在 9.21 至 9.34 秒之間,硬碟陣列不會帶來任何差異。
Q6:硬碟陣列會影響 AI 開始吐字(TTFT)或每秒生成速度(Tokens/s)嗎?
不會。硬碟只在【模型載入就緒】階段進行讀取,一旦模型進入記憶體與 VRAM,後續的提示詞預處理(Prefill)與文字生成(Generation)磁碟讀取量皆為 0,完全取決於顯示卡與 CPU 算力。
Q7:Intel VROC NVMe 陣列為什麼在 2 顆硬碟時反而比單顆慢 0.69 秒?
因為 2 顆陣列雖然增加了理論頻寬,但引入了 VROC 磁碟區管理層與 128 KiB 條帶切分(Striping)的 I/O 排程開銷,在單顆 NVMe 頻寬已過剩的情況下,額外開銷反而造成微幅負收益。
Q8:載入 25 GiB 左右的 Q8 量化模型,實際會吃掉多少記憶體與 VRAM?
以 Gemma-4-26B-A4B-IT Q8_0(25.02 GiB)搭配 n_gpu_layers=20 為例,雙張 RTX 5060 Ti 16GB 合計佔用約 17.91 GiB VRAM(單卡約 9.21 GiB 與 8.70 GiB),推論程序 RAM 工作集峰值約為 24.60 GiB。
Q9:預算有限時,該優先升級大記憶體(RAM)還是多買幾支 NVMe SSD?
優先升級大記憶體(RAM)。充足的系統記憶體能將常用模型保留在作業系統快取中,讓重啟模型的等待時間壓在 9 秒出頭,同時避免記憶體不足引發的分頁檔(Pagefile)效能崩跌。
Q10:本次實測使用的硬體與 RAID 設定是什麼?
測試於 Intel Xeon W5-3425 工作站(128GB DDR5 RAM、雙張 RTX 5060 Ti 16GB)執行,使用 Intel VROC 8.5.0.1592(128 KiB Stripe),分別測試 1 至 4 支 KINGSTON 1TB NVMe SSD 與 1 至 4 顆 WD Gold 10TB HDD。
NVMe RAID 0 跑本地 AI 實測總結與升級建議
這輪實測數據把答案講得很清楚:
- 如果你想提升 本地 AI 模型載入速度,把多支 PCIe SSD 綁成 NVMe RAID 0 幾乎沒有實質幫助,4 支陣列只比單支快 0.23 秒,2 支甚至倒退 0.69 秒。
- 把預算留給單支大容量高速 NVMe 搭配充足的 DDR5 系統記憶體,才是兼顧載入效率與硬體投資報酬率的最佳配置。
📚 Local AI 本地部署 系列
← Local AI 本地部署指南:Ollama、AnythingLLM、Whisper