自己在家玩地端 LLM,想省下買頂規旗艦卡的錢,很多人第一直覺就是上雙卡 16GB,指望花小錢就能扛住 30B 左右的大模型。但多塞一張 16GB 顯卡,拿來處理繁中長文本時,到底能少等多久?雙卡插下去,速度真的有辦法直接翻倍嗎?
當初在想要不要買兩張 16GB 顯卡時,大家最糾結的肯定是:【兩張 16GB 插上去,真的能當單張 32GB 來用嗎?】總覺得只要 VRAM 湊到 32GB 就能順跑各種大模型,但事情沒那麼單純!底層在做模型切分、吃長 Prompt 跟生成輸出時,其實處處是瓶頸。這篇直接用固定規格的工作站來抓對照,實測四款模型在單卡跟雙卡下的真實表現,把耗費秒數、首字延遲跟 VRAM 到底吃多少一次算給你看。
雙卡 16GB 跑地端 LLM 實測:4 款主流模型定位與繁中長文本測試標準
在評估雙卡硬體前,必須先建立統一且可重現的測試基準。本次評測採用工作站環境(以兩張 RTX 5060 Ti 16GB 為基準卡),統一鎖定 8,192 上下文容量(ctx8192)、批次量 512、溫度 0、雙卡層數切分 1:1,並分開記錄以下四種配置:
- 純 CPU(C0)
- 單卡 GPU 0(G0)
- 單卡 GPU 1(G1)
- 雙卡 Dual GPU(D2)
繁中長文本 4 大測試情境
所有測試都採用同一份繁體中文長文件當底稿,針對 4 種常見的實戰情境來出題。耗時計算方式很單純:確認模型載入就緒後,從按下送出 Prompt 的當下開始起算:
- 精準事實抓取(FACT):
- 要模型在長文中精確挖出最終核准的預算金額、試辦人數與資料保留天數,並標出對應的段落編號,主要考驗模型在龐大文本中「精準撈資料」的定位能力。
- 數據比對與計算(COMPARE):
- 依據文中列出的兩套方案耗時數據進行加總與比較,算出兩者差了多少時間、指出哪一案比較快,檢視模型跨段落整理數據與基礎運算的能力。
- 架構決策長摘要(SUMMARY):
- 請模型統整整篇文件的評估脈絡、候選方案、潛在風險與驗收標準。這關屬於重度長文本輸出情境,統一將上限設為 2,048 tokens,測試模型在長篇生成下的結構邏輯與回應耗時。
- 盲測防幻覺檢核(MISSING):
- 刻意詢問長文內完全沒提過的外部市價與搜尋熱度,看模型能不能老實承認「文中沒寫」並直接拒答,還是會開始自己腦補瞎掰(產生幻覺)。
4 款實測 GGUF 模型的定位與分工
- Phi-4 Q4_K_M:
- 約 14B 的純 Dense 架構(模型檔約 8.28 GiB)。這顆是標準的基礎對照組,代表單張 16GB 顯卡就能輕鬆塞下、VRAM 還綽綽有餘的輕量選手。
- Gemma-4-26B-A4B UD-Q4_K_XL:
- 總參數 26B、每次推論僅調用 4B 的 MoE 架構(模型檔約 15.84 GiB)。主要拿來實測「實際運算量雖小,但模型體積剛好卡在單卡極限邊緣」時,單卡與雙卡到底差在哪裡。
- Nemotron-3-Nano-30B-A3B UD-Q4_K_XL:
- 混合 Mamba-Transformer 的 MoE 架構(模型檔約 21.27 GiB)。體積直接衝破 16GB,非得上雙卡不可,專門用來測試吃長篇摘要以及遇到長度截斷時的推論速度表現。
- Aya-Expanse-32B Q6_K_L:
- 體積高達 25.16 GiB 的純 Dense 大模型,官方原生就對繁體中文有良好支援。這顆是真正考驗雙卡協同運算的重頭戲,用來看硬核大模型跨入雙卡後,能榨出多少實質效益。
實測硬體規格
| 品名 | 型號/規格 |
|---|---|
| CPU | Intel Xeon w5-3425 |
| 主機板 | Supermicro X13SWA-TF |
| 記憶體 | DDR5 4*32GB 4800MT/s |
| GPU | 2 * RTX 5060 Ti 16GB |
| 作業系統 | Windows 11 |
兩張 16GB 顯卡真能當 32GB 跑?破解地端雙卡升級三大迷思
在 Reddit 的 Local LLaMA 板或各大硬體社群裡,聊到雙卡配置時,不少人常有幾項【美好的直覺假設】;但實際拉上工作站實測後,現實往往跟想像差很多。
迷思一:多買一張顯卡,所有模型的運算速度都會直接翻倍?
實測真相:
這完全取決於模型大小與 VRAM 需求。如果模型本來就能整顆塞進單張 16GB(比如常見的 14B 模型),多插一張卡不僅速度不可能翻倍,甚至還得平白承擔跨 PCIe 傳輸與模型各層同步的 Overhead(額外耗損),前後測出來的差距可能只有少得可憐的幾百毫秒,日常使用根本無感。
迷思二:兩張 16GB 顯卡加起來,就等於一張 32GB VRAM 的頂規怪獸卡?
實測真相:
像 llama.cpp 這類推論引擎,底層跑的是【 層數切分(Layer Split)】,並不是在硬體層面把兩張卡的記憶體融合成一塊連續的 32GB 記憶體池(Memory Pool)。兩張卡依然各自受限於 16GB 的實體邊界,而且各自都必須預留 Context 快取與運算暫存空間,絕對不能天真地直接以 16 + 16 來算可用容量。
迷思三:第一個字跳得快(首字延遲低),就代表整個任務很快能跑完?
實測真相:
首字跳出來的時間(TTFT)只反映了模型吃進長 Prompt(Prompt Processing / Prefill)的速度;但整個回應跑完的總耗時,關鍵還是在後面逐字吐出 Token(Token Generation)的每秒產出吞吐量。在實測與日常體驗中,這兩階段帶來的等待體感完全是兩碼子事。
雙卡 16GB 地端 LLM 實測對決:兩張 16GB 顯卡真能當 32GB 跑?真實效能數據大公開
這裡直接調出 10 張實測圖表對照。為求客觀與穩定,每項情境皆重複測試 3 次並取中位數(Median),同時標出最大與最小值的波動區間。
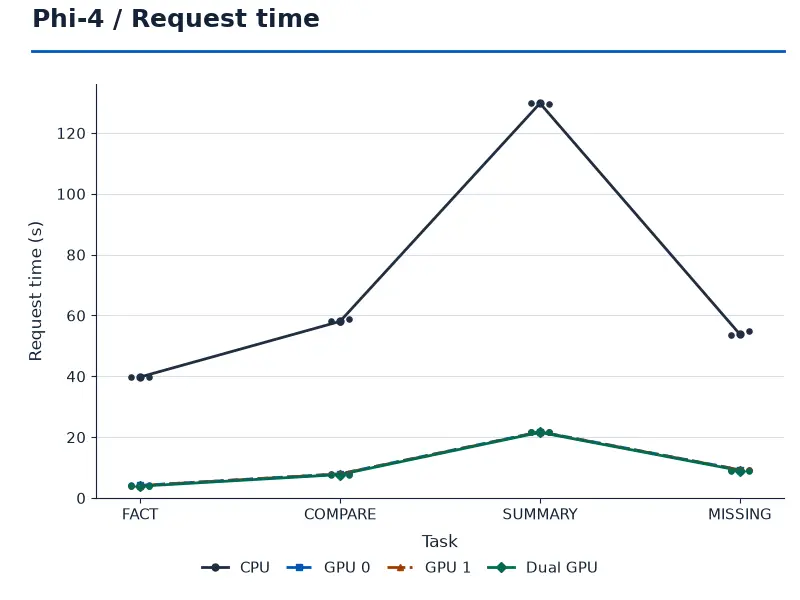
輕量模型:Phi-4 Q4_K_M 推論總耗時
輕量模型在不同硬體配置下的推論秒數表現:
- 純 CPU(C0):
- 啃繁中長文本相當吃力,FACT 需 39.76 秒,長篇 SUMMARY 更拖到了 129.77 秒。
- 單卡(GPU 0 (G0) / GPU 1 (G1)):
- 一交給顯卡推論,速度立刻暴衝。FACT 縮短到 4.13 秒(G0)與 4.09 秒(G1),SUMMARY 也壓在 21.79 秒與 21.70 秒。
- 雙卡(Dual GPU / D2):
- FACT 耗時 3.88 秒,SUMMARY 則是 21.57 秒。
從下圖可以清楚看到,GPU 0、GPU 1 與 Dual GPU 的曲線幾乎完全重合,單卡與雙卡差距僅有 0.2 秒上下。
實測結論很直白: 像 14B 這種單張 16GB 就吞得下的模型,硬上第二張顯卡幾乎榨不出任何提速價值。
混合架構:Gemma-4-26B-A4B 與 Nemotron 30B 總耗時
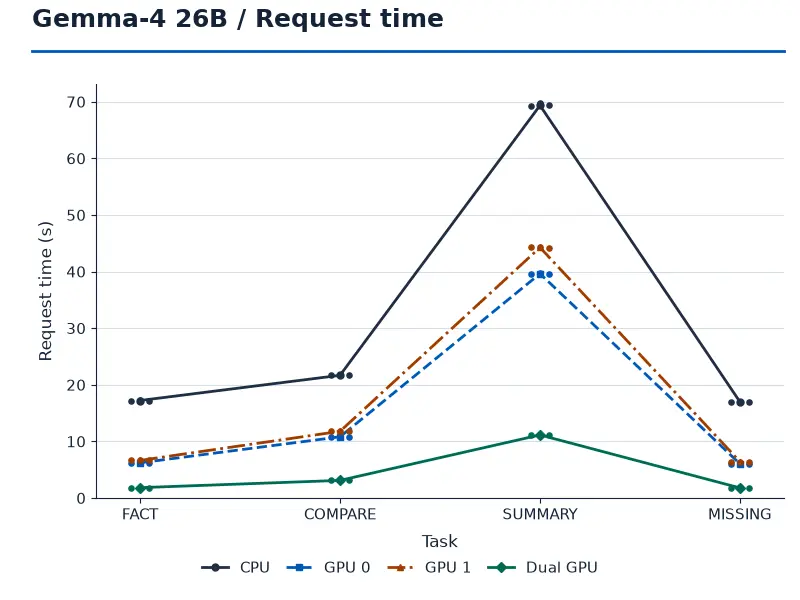
當模型體積逼近甚至超出單卡 16GB 上限時,雙卡的優勢才真正爆發:
Gemma-4-26B-A4B
- FACT:
- 單卡需耗時 6.22 秒(G0)與 6.64 秒(G1),雙卡直接壓到 1.83 秒。
- SUMMARY:
- 單卡各需 39.63 秒(G0)與 44.26 秒(G1),雙卡直接縮短到 11.14 秒,足足省下了將近 75% 的乾等時間。
Nemotron 30B
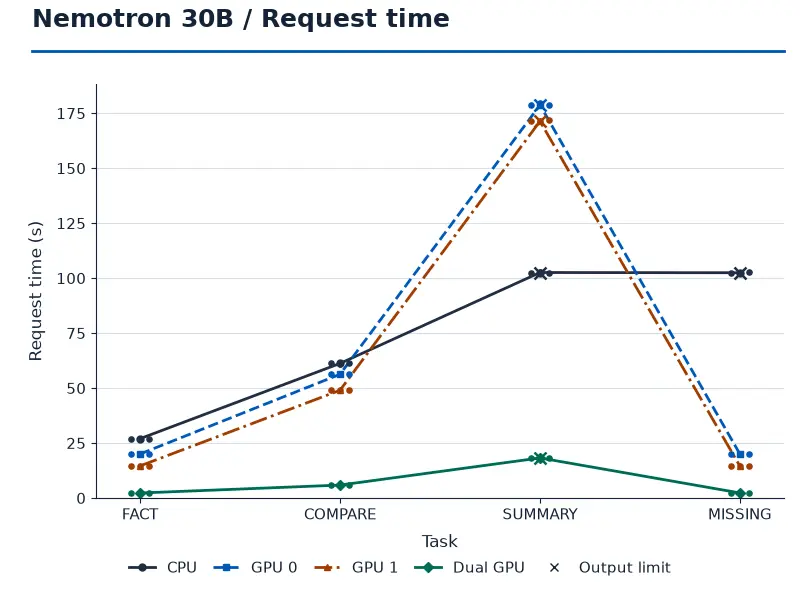
Nemotron 30B 則點出了一個關鍵陷阱 – 任務是否真的有跑完:
- 在長篇 SUMMARY 關卡中,純 CPU(102.55 秒)、單卡(G0 178.73 秒 / G1 171.35 秒)與雙卡(18.22 秒)全部都標記了叉號「×」(代表撞到 2,048 tokens 輸出上限而被強制截斷)。
- 雙卡測出的 18.22 秒,純粹是因為推論速度極快而「提早撞牆」,千萬別誤看成【它只花 18 秒就生出了高水準摘要】,解讀數據時一定要看清這個中斷標記。
重量級負載:Aya-Expanse-32B 總耗時
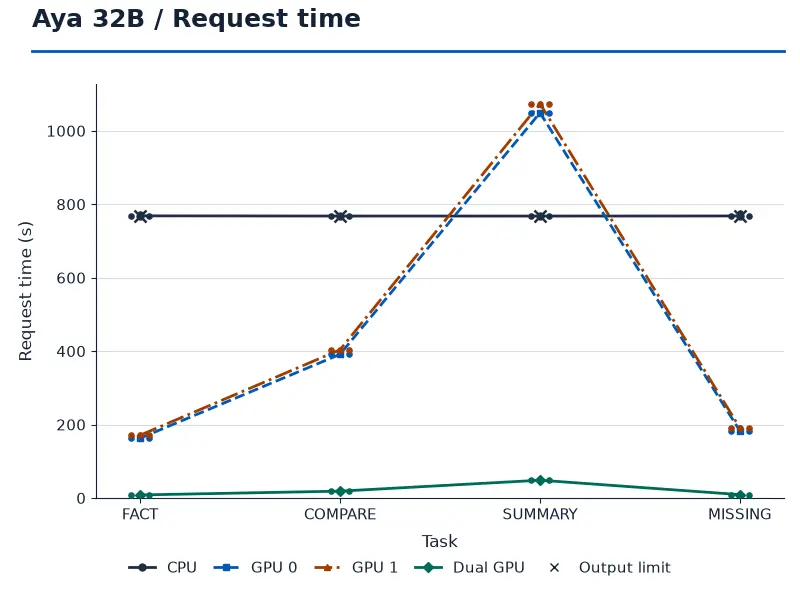
面對 25.16 GiB 純 Dense 大模型時的極限殘酷舞台:
- 純 CPU:
- 4 項測試情境全數撞頂 2,048 tokens 遭截斷(平均耗時約 768 秒,等了快 13 分鐘)。
- 單卡(GPU 0 (G0) / GPU 1 (G1)):
- 因為單卡 VRAM 完全吃不下,大量模型層被踢回系統 RAM,SUMMARY 耗時直接飆破 1,049.07 秒與 1,073.91 秒(整整卡死超過 17 分鐘)。
- 雙卡(Dual GPU):
- 成功把所有模型層完整 Offload 進兩張顯卡,FACT 只要 8.31 秒,SUMMARY 也大幅縮短到 48.42 秒,而且每一次產出都是正常結束符號(EOS),實用價值是天壤之別。
體感靈魂:首字回應時間(TTFT)
記錄了從按下送出 Prompt 到螢幕開始跳出第一個字的真實秒數:
Phi-4
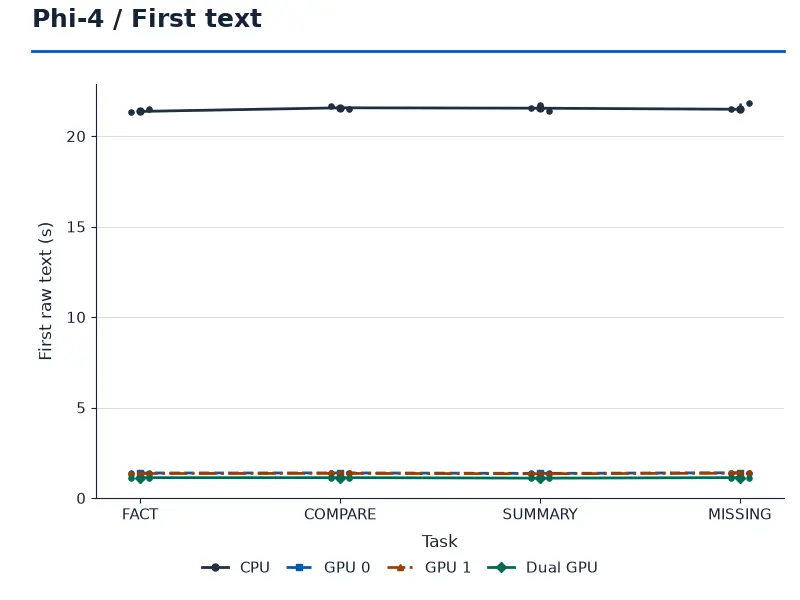
單卡等首字大概 1.35~1.38 秒,雙卡約 1.10~1.12 秒,操作體感上幾乎都是隨按隨回,差別不大。
Aya 32B
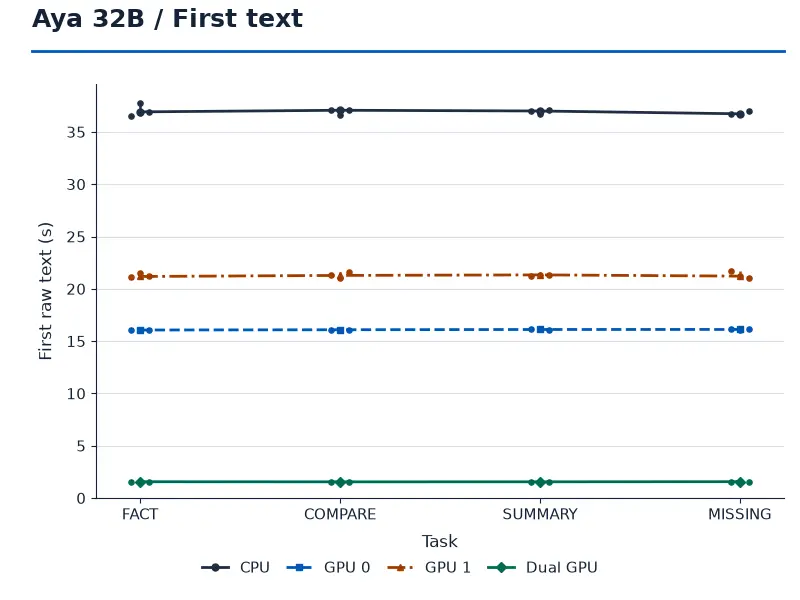
- 單卡跑的時候,送出提問後必須死盯螢幕乾等 16.06 秒(G0)到 21.18 秒(G1)畫面才有反應
- 換上雙卡後,首字延遲瞬間掉到 1.55 秒,徹底消除了長文本丟進去時那種宛如當機的卡頓感
系統記憶體(RAM)與每卡 VRAM 峰值消耗剖析
拆解了上雙卡後,底層記憶體實際的配置現況:
行程主記憶體(Process RAM)
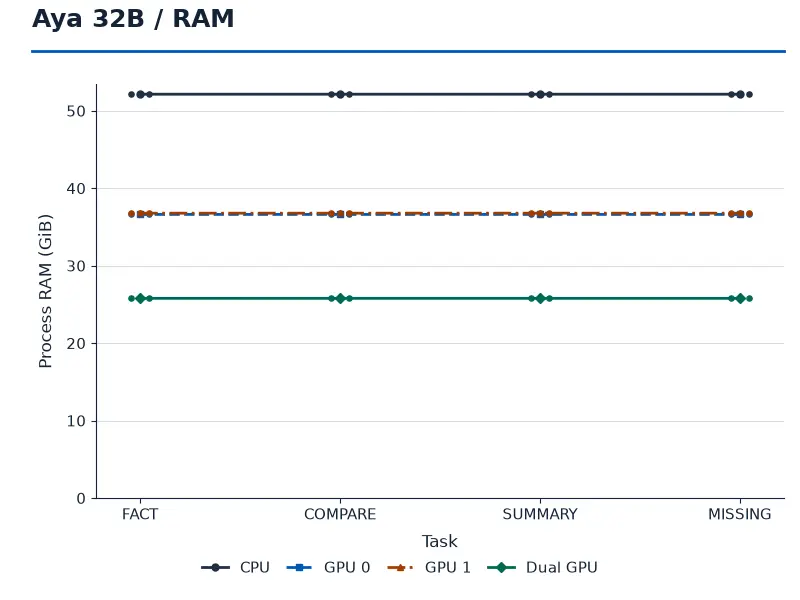
- Aya 32B 在純 CPU 模式下會吃掉高達 52.13 GiB 的系統 RAM;
- 單卡模式下也得佔用 36.61~36.77 GiB;
- 改用雙卡後,因為模型層完整倒進顯卡,系統 RAM 吃量降到 25.78 GiB。
- 要是主機原本只配備 32GB RAM,跑單卡時鐵定瘋狂觸發系統分頁檔換頁(Paging),整台電腦直接凍結。
單卡 VRAM 峰值
- 單卡測試時,
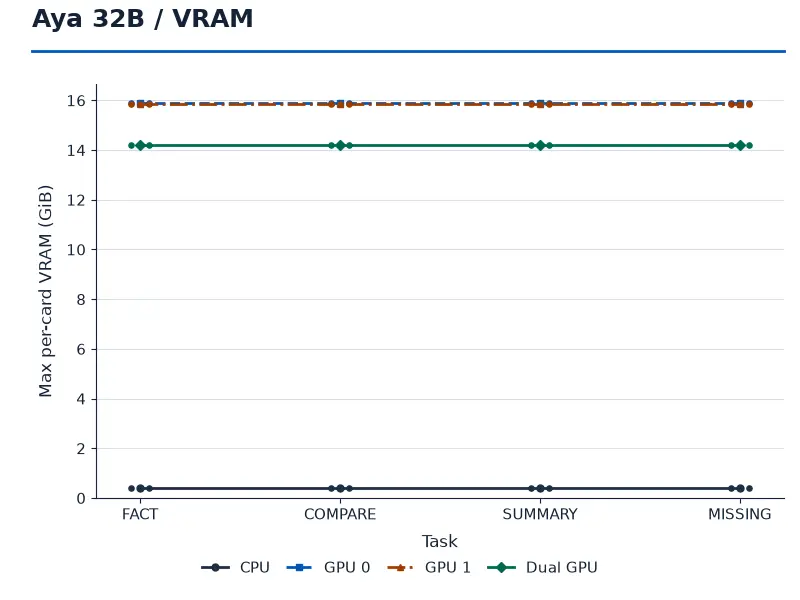
- G0 峰值來到 15.88 GiB
- G1 則是 15.86 GiB
- 直接把 16GB GPU 撐到緊繃邊緣
- 切到雙卡後,吃最多的一張卡降到 14.22 GiB(另一張卡約吃 13.26 GiB)
- 這也再次印證:雙卡是各自切分負載,絕不是在硬體層合體成無縫的單一 32GB 大水庫
GPU Layers 催到底一定最快?雙卡防踩雷指南與 4 步調校法
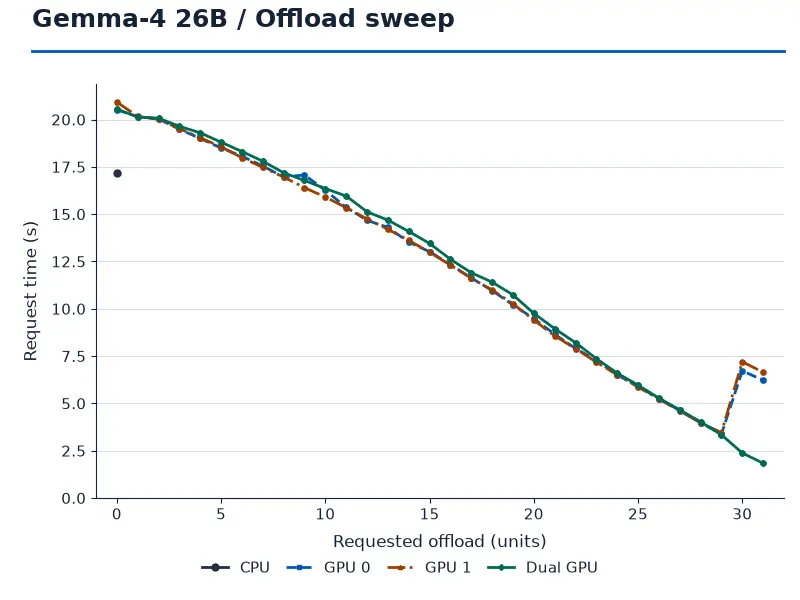
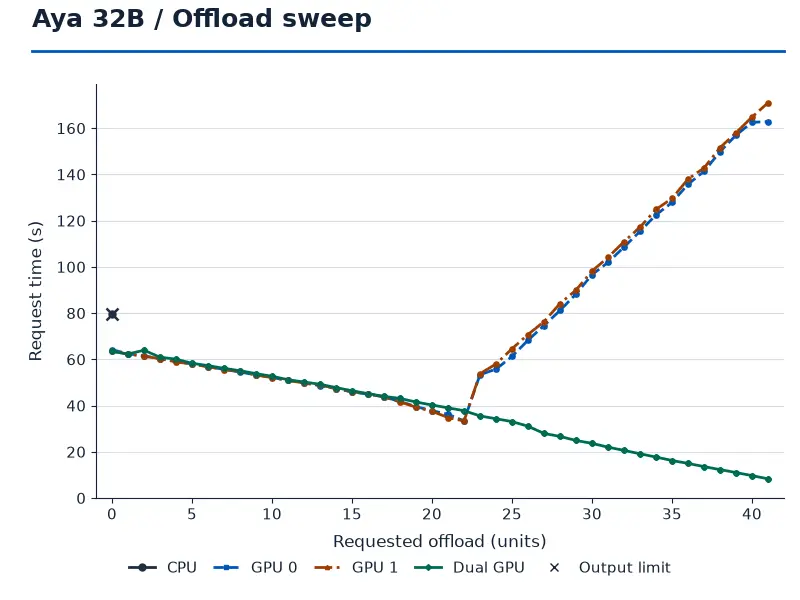
在 llama.cpp 官方效能討論串與開源專案 club-dual-5060ti 中,不少新手調整參數時,直覺就是把要卸載進顯卡的層數(Offload Layers)無腦催到底。但我們這次在做短 FACT 探索測試時,抓到了一個非常關鍵的反常現象:
單卡塞到極限時的「耗時反彈飆升」現象
Gemma-4 26B
- 單卡把層數從第 0 層一路加到第 29 層時,耗時很漂亮地從 20.5 秒線性壓到 3.38 秒
- 但當硬要塞進最後的第 30 與 31 層時,耗時不減反增,直接翻倍反彈回 6.72 秒與 7.20 秒。
Aya 32B
- 單卡設在第 22 層時耗時 33.37 秒
- 從第 23 層起一路失控飆高
- 若自作聰明催滿到第 41 層,耗時居然直接衝到 162.83 秒,整整慢了快 5 倍
- 反觀雙卡(Dual GPU)因為空間充裕,耗時一路順暢遞減,在第 41 層直接壓在 8.30 秒的極速。
背後原因拆解
當單卡把 VRAM 吃得一滴不剩時,系統根本沒空間配置運算暫存與 Context 快取(KV Cache),導致資料被迫在 VRAM 與系統記憶體之間瘋狂來回搬移,把 PCIe 頻寬直接打爛,引發極為嚴重的延遲瓶頸。
避雷必看的 4 個實戰調校步驟
- 實施逐層摸底測試(Offload Sweep):
- 千萬別盲目把層數填 999 或直接拉到頂,建議從安全層數開始一段一段往上測,抓出單卡效能開始反彈跳水的臨界點。
- 務必替 Context 快取預留餘裕:
- 算 VRAM 絕對不能只看靜態的模型權重檔大小。跑長文本 Prompt 時,吃掉的 KV Cache 非常可觀,每張卡至少要預留 1.5~2GB 的 VRAM 緩衝空間才穩。
- 主機系統記憶體(RAM)請直上 64GB:
- 實測證明跑 30B 大模型時,就算上了雙卡,系統 RAM 依然會吃掉將近 26 GiB;跑單卡更會吃破 36 GiB。要是主機只插 32GB RAM,分頁檔一爆電腦就直接凍結給你看。
- 分清楚【跑完】跟【答對】是兩碼子事:
- 這次實測的正式回答中,程式狀態顯示 Success 僅代表模型順利吐出字串且沒有崩潰;至於長篇摘要有沒有因為撞到 2,048 tokens 上限被硬生生腰斬、內容有沒有漏抓細節,最後還是得靠人工檢視才算數。
雙卡 16GB 地端 LLM 常見問答集
Q1:在地端自架 AI,組雙卡 16GB 跑 30B 模型顯存夠嗎?能直接當一張 32GB 顯卡用嗎?
A1:沒辦法直接當成單張 32GB 顯卡來算。
地端推論是透過 llama.cpp 等推論引擎,把模型的神經網路層數切分(Layer Split)分開丟給兩張卡跑,每張卡依然死守各自 16GB 的硬體上限。
跑 30B 等級(如 Q4/Q5 量化)的模型權重檔確實能吞下,但只要一丟進萬字繁中長文本,兩張卡都得各自預留 KV Cache 暫存空間,絕不能天真地把 16+16 的數字當作完全可用的記憶體池。
Q2:兩張 5060 Ti 跑 LLM 速度如何?升級雙卡後速度真的能直接翻倍嗎?
A2:完全不會翻倍!
如果平時只跑小模型(例如:Llama 3 8B),單張 16GB GPU 本來就吃得下的模型,單卡跟雙卡速度幾乎平手,差距只有 0.2 秒左右,甚至雙卡還多了跨 PCIe 傳輸與層間同步的微幅耗損。
雙卡的真正價值不是【讓小模型速度翻倍】,而是【能跑原本跑不動的大模型】,讓單卡原本會爆記憶體卡死的 26B MoE 或 32B 大模型,從跑不動變成能在幾十秒內順暢產出。
Q3:調校參數時,GPU offload layers 拉滿變慢原因是什麼?層數不是塞越多越快嗎?
A3:當把所有層數通通塞進顯卡、把 VRAM 壓榨到最後 1MB 時,系統會完全擠不出空間放運算暫存與 Context 快取。
這時候推論引擎只能被迫把資料往主機板 RAM 來回搬移,被極慢的系統記憶體頻寬拖累,整體耗時反而會雪崩式暴增好幾倍。
最穩的做法是每一張卡都手動預留 1.5GB 到 2GB 的 VRAM 餘裕給快取。
Q4:處理長文件時,地端 LLM 首字延遲太慢解決方法有哪些?雙卡會有幫助嗎?
A4:非常有感。
首字延遲(TTFT)反映的是模型消化吃進去長 Prompt(Prefill 階段)的運算速度。
以 32B 大模型為例,單卡跑的時候因為顯卡記憶體不夠、大量層數掉在系統 RAM,按送出後往往要在螢幕前乾等 15 到 20 秒畫面才會動。
一旦改上雙卡把模型層全部收進 VRAM,首字延遲能瞬間壓到 1.5 秒左右,徹底擺脫像是當機的漫長等待感。
Q5:組雙卡工作站時,主機板跑雙顯卡 PCIe x8 x8 影響推論效能嗎?
A5:在模型逐字吐出 Token 的生成階段影響不大,因為此時運算瓶頸主要卡在顯卡自身的記憶體頻寬;但如果在處理【長文本 Prompt 編碼(Prefill)】或跨卡頻繁傳遞中間特徵層時,PCIe 頻寬不足就會讓首字延遲稍微被拉長。
組機時強烈建議挑選支援 CPU 直連分流(如 x8 + x8)的主機板,盡量避免讓第二張卡走延遲高、頻寬窄的 PCH 晶片組通道。
Q6:插兩張顯卡,主機板跑 32B 大模型電腦記憶體要幾GB才不會遇到系統凍結?
A6:強烈建議系統 RAM 至少直上 64GB!
許多人以為上了雙卡就不吃主機記憶體,但實測跑 Aya 32B 這類大模型時,模型載入與底層運算快取依然會吃掉將近 26GB 的系統 RAM。
如果中途想退回單卡測試,吃量更會飆破 36GB。
要是主機只插 32GB RAM,分頁檔(Pagefile)一滿系統就直接凍結甚至程式崩潰。
Q7:Gemma 4 MoE 單卡雙卡推論差異有哪些?MoE 架構上雙卡到底差在哪?
A7:主要差在【模型總體積】與【運算負擔】的平衡點。
像 Gemma 4 26B-A4B 每次運算雖然只調用 4B 參數,但模型檔本體逼近 16GB。在單卡上執行長篇摘要時,因為吃滿 VRAM 導致推論耗時拖到 40 秒以上;改上雙卡後,兩張卡能輕鬆容納全部專家權重與長文本快取,推論時間直接驟降到 11 秒左右,足足省下近 75% 的乾等時間。
Q8:到底該挑單張 24GB 還是雙卡 16GB 划算?地端玩家怎麼選?
A8:單張 24GB 最大的好處是省事,完全不用煩惱雙卡散熱風道、電源供應器瓦數與 PCIe 插槽分配。
但雙卡 16GB 的最大優勢在於能湊出高達 32GB 的 VRAM 總量,而且能用分期添購的方式升級。
如果你打定主意要順跑 25GB 以上的 32B Dense 旗艦模型,單張 24GB 依然塞不下,雙卡 16GB 才能提供真正的容納空間。
Q9:遇到地端跑繁中長文本 Context 爆顯存時,該怎麼調整才能兼顧速度又不會爆掉?
A9:長文本推論最吃 VRAM 的元兇是 KV Cache。
遇到顯卡記憶體吃滿時:
第一步請在推論引擎中啟用快取量化(例如將 KV Cache 改設為 Q8_0 或 Q4_0),直接幫 Context 省下一半空間。
第二步則是適度調降單卡的 Offload 層數,手動留出 2GB 左右的緩衝區,才不會因記憶體溢位而強制呼叫虛擬記憶體拖慢全機。
Q10:llama.cpp 雙卡層數分配教學,參數 tensor-split 該怎麼設才最穩?
A10:如果是兩張同規格的 16GB 顯卡,最直覺的參數是設定 –tensor-split 1,1 平均分攤。
但實務上強烈建議設為 0.9,1.1 或依負載微調。
因為主顯卡(GPU 0)通常要額外負擔螢幕畫面輸出、推論運算圖排程與最後的 Output 層,吃量天生比副卡多幾百 MB。
稍微少分一點層數給主卡,可以避免主卡先爆 VRAM 而副卡還很空閒的窘境。
雙卡 16GB 跑地端 LLM 真能當 32GB?看清需求再決定升級策略
總結來說,雙卡 16GB 地端配置沒辦法直接當成單張 32GB VRAM 來用,但確實是突破單卡瓶頸的升級好物。平時若只跑 14B 模型,單卡就很夠用;但若想順跑 26B MoE 或 32B 處理繁中文檔,雙卡能把十幾分鐘的乾等縮到幾十秒搞定,實戰 CP 值極高。與其訂閱 Google AI Pro 當程式開發白老鼠狂踩雷,不如把預算拿來架雙卡地端,速度看得見、隱私自己掌控。

📚 Local AI 本地部署 系列
← Local AI 本地部署指南:Ollama、AnythingLLM、Whisper